[PL] Abstract Data Types and Encapsulation Concepts
'프로그래밍 언어' 시리즈
- [PL] Preliminaries
- [PL] Names, Bindings, Type Checking, and Scopes
- [PL] Data Types
- [PL] Expressions and the Assignment Statement
- [PL] Statement-Level Control Structures
- [PL] Subprogram
- [PL] Implementing Subprograms
- [PL] Exception Handling and Event Handling
- [PL] Abstract Data Types and Encapsulation Concepts
- [PL] Object-Oriented Programming
✦ The Concept of Abstraction
◆ Abstraction
- Abstraction : 해당 범주의 본질적 속성 (essential attribute)
- 어떤 process 나 category 가 속성의 부분집합 만으로 표현될 수 있음
- 본질적 속성에 집중, 부수적 속성 무시 가능
- Abstract Data Type : 데이터 추상화에 대한 언어 지원
◆ Two Kinds of abstractions in PL
- Process Abstraction
- 모든 subprogram 은 process abstraction 이다
- 어떻게 수행되는지 몰라도 수행 가능
- Example
- 정렬 : Bubble sort, Quick sort → 본질적 속성 : 정렬될 배열, 원소의 타입, 배열 길이 (실제 구현 방식 X)
- Data Abstraction
- 표현 (representation) & 구현 세부사항이 숨겨짐
✦ Introduction to Data Abstraction
- Data-oriented programming : 프로그래밍 방법론. process 추상화 이후에 발견
◆ Floating-Point as an Abstract Data Type
- 내장 타입 (built-in type) → 추상 데이터 타입
- 변수 생성 수단 제공
- 객체 조작 위한 산술 연산 집합 제공
- 정보 은닉 (Information Hiding)
- memory 에 실제 어떻게 저장되어 있는지 은닉 & 조작 불가능
- 시스템 제공 연산 외 new 연산 생성 불가
- 유연한 데이터 표현 가능 & 프로그램 이식성 (program portability) 허용
◆ User-Defined Abstract Data Types
- (User-Defined) Abstract Data Type
- Encapsulation : 표현, 정의, 객체 연산이 단일 구문 단위 (single syntactic unit) 안에 기술 → grouping / compilation unit
- Information hiding : 타입 정의에서 제공된 연산 외 연산 사용 불가
- 장점
- Localized modification (지역화된 수정) : by Encapsulation. 표현은 그 타입을 사용하는 프로그램 단위에 영향 없이 변경 가능
- Increased reliability (신뢰성 증가) : by Information hiding. basis 표현 변경 불가 → 객체의 무결성 (integrity) 증가
◆ Example : Stack
- Operation
create(stack)
destroy(stack)
empty(stack)
push(stack, element)
pop(stack)
top(stack)
- Usage
int i, k;
stack STK1, STK2;
....
push(STK1, COLOR1) ;
push(STK1, COLOR2) ;
...
if (not empty(STK1)) then TEMP := top(STK1) ;
...
push(STK2, TEMP) ;
......
- ADT 목표 : 데이터 객체가 아닌, 추상적 속성에만 의존해 작성하도록 기능 제공
✦ Design Issues for Abstract Data Types
- ADT 위한 요구 사항
-
캡슐화 구성 : 타입 정의 & 함수들 한묶음으로 만들 수 있는 문법 존재 ex) C++, Java
class - 인터페이스 노출 : 타입 이름 & 함수의 header 는 공개, 내부 구현 hide
- 기본 연산 자동 제공 : 대입 & 동등 비교 등은 기본적으로 사용 가능해야 함
-
- 캡슐화 구현 철학
- 1 캡슐화 단위 = 1 type → 현대 OOP 언어 (C++, Smalltalk)
- 1 캡슐화 단위 = 여러 엔티티
→
namespace유사 (Ada, Modula-2)
- Design Issue
- 어떤 타입을 추상화 가능?
- generic 지원?
- 이름 충돌 처리?
✦ Language Examples
◆ SIMULA 67 의 Class
- 최초로 데이터 추상화 직접적 지원
- Encapsulation
- Data & Procedure 를 한 묶음으로 묶을 수 있음
- 구문 형식
class class_name ;
begin
  -- class variable definition --
  -- class subprogram definitions --
  -- class code section --
end class_name ;
- 인스턴스는 동적으로 생성. 포인터 변수로만 참조 가능
- Information Hiding : 완전히 제공 X
◆ Abstract Data Types in Ada
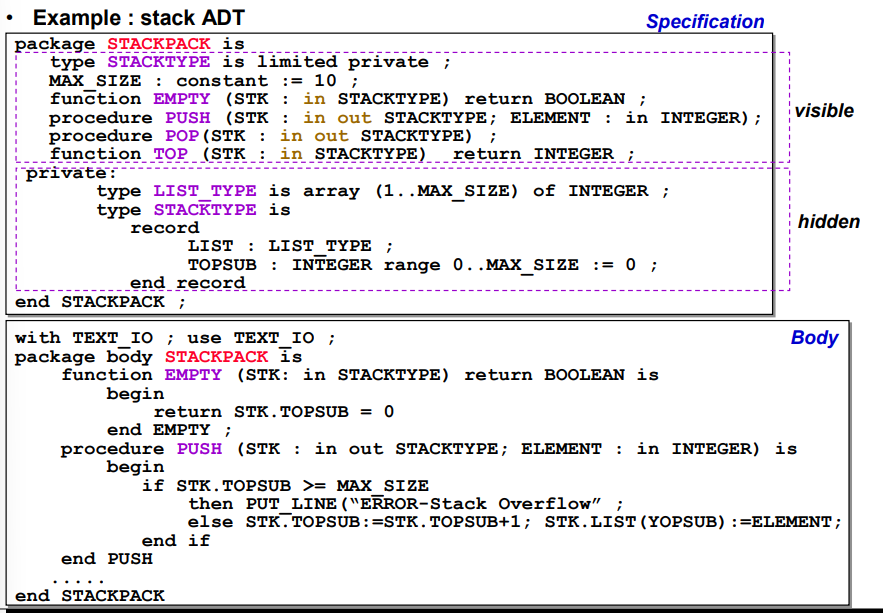
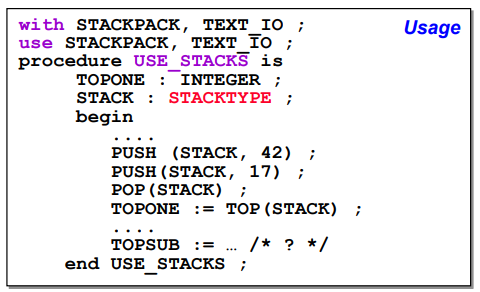
- Encapsulation
- Ada 에선 pakage 라고 불림
- specification package (명세 패키지)
- body package (본체 패키지)
- Ada 에선 pakage 라고 불림
- Information Hiding
- Specification 은 두 섹션 가짐
- visible 한 부분
- private 한 부분
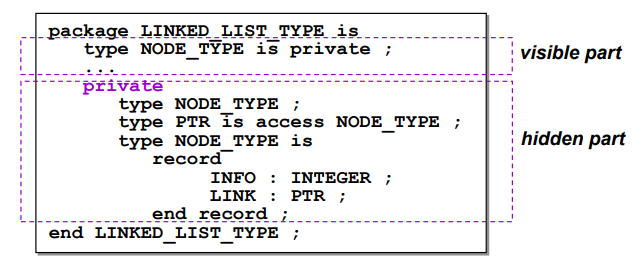
- Specification 은 두 섹션 가짐
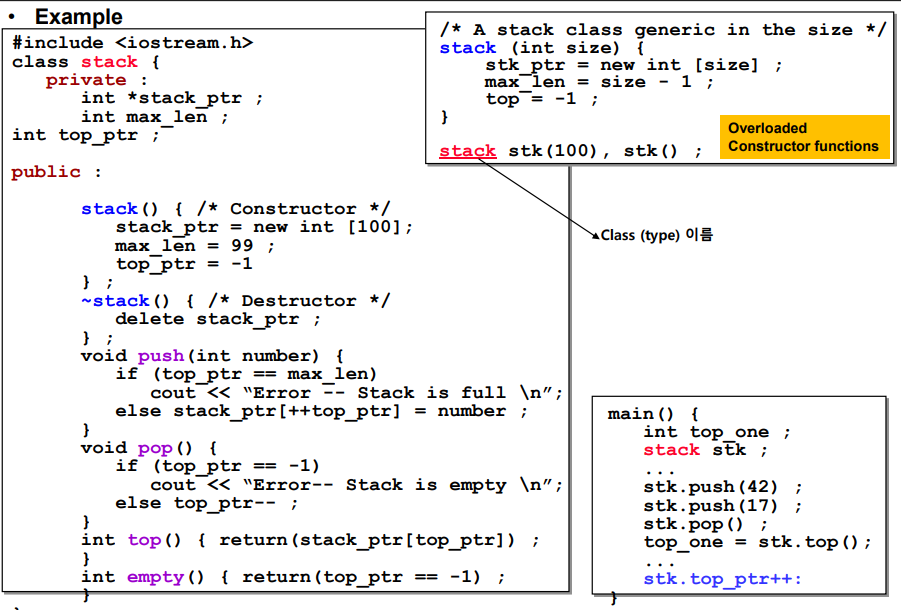
◆ Abstract Data Types in C++
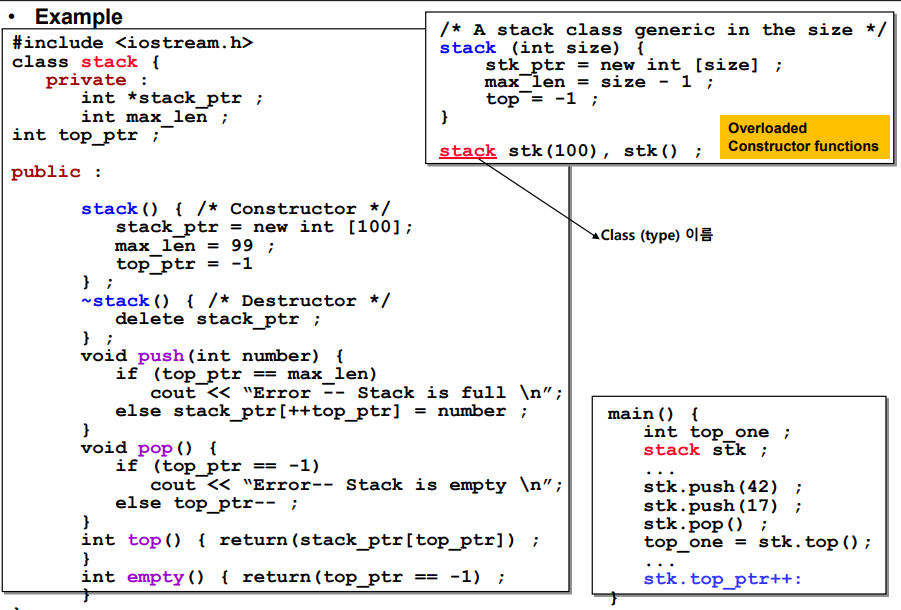
- C언어 + OOP 지원 →
class로 data abstraction 지원 - 캡슐화 (Encapsulation) →
class- data type 위한 템플릿. 여러 번 instance 만들 수 있음
- data member : 인스턴스 변수
- member function : 메소드 (함수)
- instance
- data member 는 각 instance 마다 다름
- member function 은 공통적으로 사용 가능
- object (객체) = instance
- static : global 영역
- semidynamic : 객체 선언 정교화 (elaboration) 의해 생성 (stack 영역)
- explicit dynamic :
new,delete의해 명시적 생성 / 삭제 (heap 영역)
- data type 위한 템플릿. 여러 번 instance 만들 수 있음
- 정보 은닉 (Information Hiding)
- 접근 제어자
private: 엔티티 숨기기public: 엔티티 보이기 (class interface)protected: subclass 와 관련
- constructor : 객체가 생성될 때 자동 호출
- 암묵적 호출 → 깨끗한 초기 상태 보장
- 매개 변수 받을 수 있음
ClassName()
- destructor : 객체가 사라질 때 자동 호출
- 암묵적 호출 → 자원 누수 방지
~ClassName()→ RAII (Resource Acquisition Is Initialization)
- 접근 제어자
◆ Abstract Data Types in Java
- C++ 과 유사
- 차이점
struct존재 X, 사용자 정의는 모두class사용- 모든 object 는
new로 heap 에 할당 → reference variable (참조 변수) 의해 접근 - class 파일 안에 선언 & 정의 한번에 (C++ 처럼 .h, .cpp 나누지 않음)
- destructor X → garbage collector 가 메모리 정리
| 항목 | C++ | Java |
|---|---|---|
| 사용자 정의 타입 | class, struct, union, enum | class만 (record는 최근 추가) |
| 객체 할당 위치 | 스택/힙/정적 모두 가능 | 힙만 |
| 변수와 객체 관계 | 값 또는 포인터 | 항상 참조(reference) |
| 선언/정의 분리 | 가능 (.h / .cpp) | 불가능 (한 파일) |
| 메모리 해제 | 수동 (delete 또는 RAII) |
자동 (GC) |
| 소멸자 | 있음 (~ClassName) |
없음 |
| 자원 관리 패턴 | RAII | try-with-resources |
class StackClass {
  private:
        private int [] *stackRef;
        private int [] maxLen, topIndex;
        public StackClass() { // a constructor
                stackRef = new int [100];
                maxLen = 99;
                topPtr = -1;
        };
        public void push (int num) {…};
        public void pop () {…};
        public int top () {…};
        public boolean empty () {…};
}
✦ Parameterized Abstract Data Types
- Generic / Parameterized ADT
- C++ 의
template<class T>, Java 의<T>
- C++ 의
- 필요 이유
- 만약 없으면 type 마다 class 따로 만들어야 함.
class IntStack {     // int 전용
    int data[100];
    void push(int x);
    int pop();
};

class FloatStack {   // float 전용
    float data[100];
    void push(float x);
    float pop();
};

class StringStack {  // string 전용
    string data[100];
    void push(string x);
    string pop();
};
// ... 끝없이 ...
- 한 번 정의하고
<>안에 type 바꿔서 활용
template<class T>
class Stack {    // T가 무엇이든 OK!
    T data[100];
    void push(T x);
    T pop();
};

Stack<int> s1;       // int 스택
Stack<float> s2;     // float 스택
Stack<string> s3;    // string 스택
공유하기
Twitter Facebook LinkedIn글 이동
시리즈 이동
Comments