[Algorithm] Probabilistic Analysis and Randomized Algorithms
'알고리즘 설계와 분석' 시리즈
- [Algorithm] Introduction
- [Algorithm] Divide-and-Conquer
- [Algorithm] Probabilistic Analysis and Randomized Algorithms
- [Algorithm] Heapsort and Quicksort
- [Algorithm] Sorting in Linear Time Medians and Order Statistics
- [Algorithm] Hash Tables
✦ Probabilistic Analysis
- 확률적 분석
◆ Hiring Problem
- 회사에서 직원을 채용하려함
- 후보자 마다 비용 有
- c_i : agency 비용 → 고정 발생
- c_h : 고용 비용 → 기존 사람보다 나을 때만 발생
HIRE_ASSISTANT(n)
best = 0
for i = 1 ~ n // interview 는 모두
	interview candidate i
	if candidate i > candidate best
		best = i
		hire candidate i
- 총 cost : O(c_in + c_hm)
- c_in 은 고정. c_hm 줄이는 방법?
- worst case : 오름차순 O(c_in + c_hm)
- best case : 내림차순
- 전체 비용 결정 → candidate 이 오는 순서
- c_in 은 고정. c_hm 줄이는 방법?
◆ Probabilistic Analysis
- 입력 값에 따라 비용 결정
- 입력값이 어떤 특정을 지니는지 모델링 ⇒ 확률
- 확률을 이용해 average case 구하기
- ex) Hiring Problem
- 각 candidate 를
i, 능력을rank(i)의 unique 한 값으로 가정 -
전체 능력을 순열로 표현 가능 → <rank(1), rank(2), …, rank(n)> → 이때 가능한 순열의 경우의 수 : n!
- 각각의 순열이 나타날 수 있는 확률은 모두 동일하다고 가정 → Uniform random permutation
- 각 candidate 를
◆ Indicator Random Variables
→ 지시 / 지표 확률 변수
- 실제 확률적 분석 도구
$$
\mathrm{I}\{A\} =
\begin{cases}
1 & \text{if } A \text{가 발생하면}, \\
0 & \text{if } A \text{가 발생하지 않으면 }.
\end{cases}
$$
→ binary 문제만 적용 가능
-
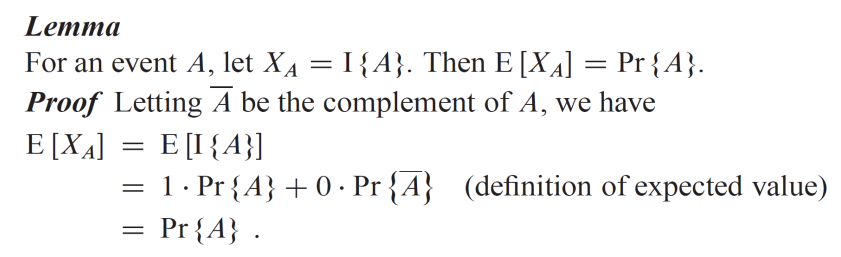
지시 확률 변수의 기댓값 (E[X_a]) = 사건이 일어날 확률 (\Pr{A})
-
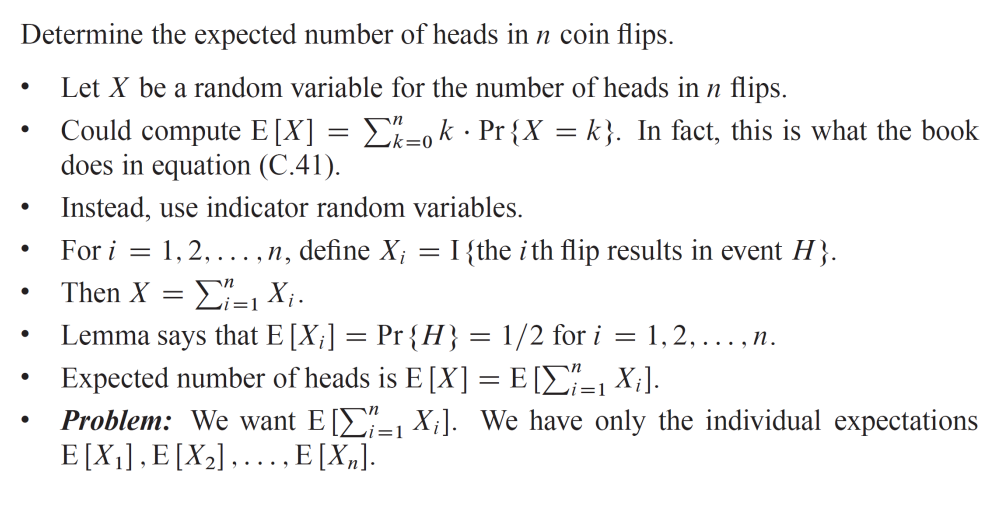
ex) 동전 던지기
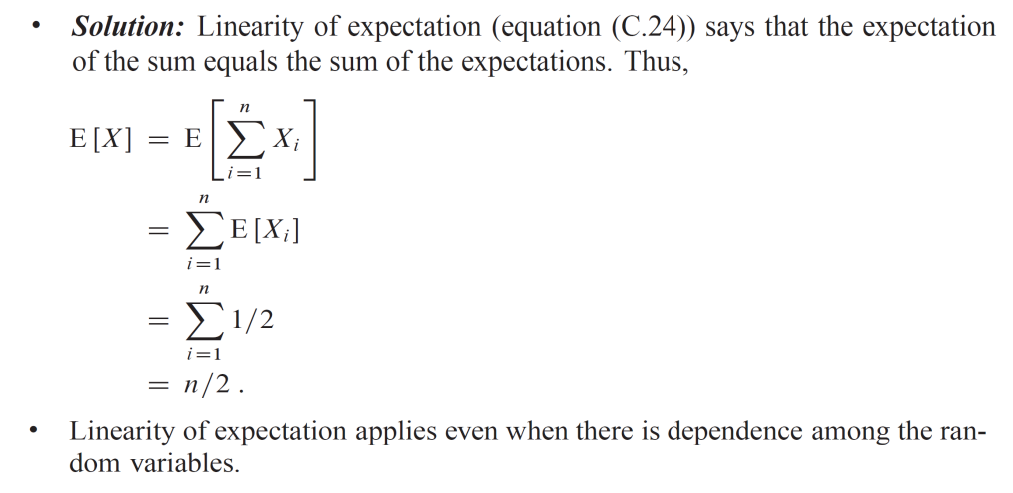
- 지시 확률 변수 (indicator random variables) 로 구하면?
- X =X_1 \sim X_n 까지 더하기
- E[X] = E[\sum_{i=1}^nX_i]
- 기댓값의 선형성 → sigma 를 앖으로 뺄 수 있음
- \displaystyle\sum^n_{i=1}E[X_i] = \displaystyle\sum^n_{i=1}\frac{1}{2} = \frac{n}{2}
- 동전 앞면 나올 기댓값 → \frac{n}{2}
- 확률 분석으로 얻은 실행 시간 → average time cost
◆ Analysis of the Hiring Problem
- 고용 O → 1 고용 X → 0
- X_i = I → i 가 고용돰
- i 가 고용될 확률 \Pr = \frac{1}{i}
- 1 ~ i-1 까지의 candidate 가 i 보다 worse 해야 함
- E[X_i] = \frac{1}{i}
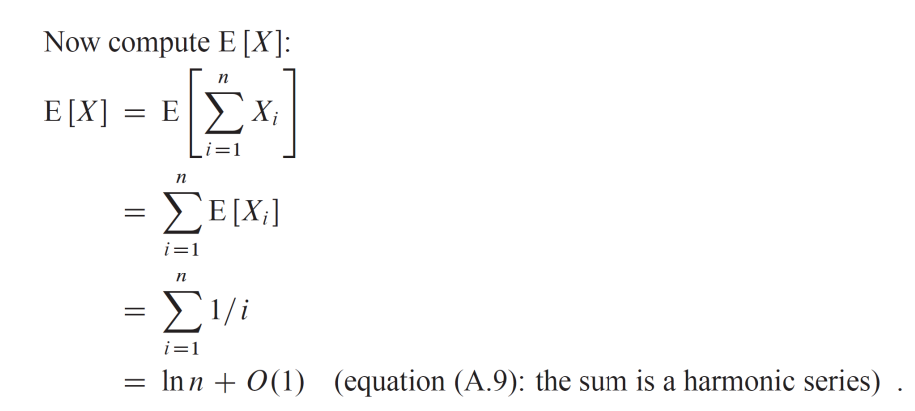
- 전체 Hiring code = O(c_h \ln n) → worst case O(n^2) 보다 나음
✦ Randomized Algorithms
- 무작위 알고리즘
◆ Randomized Algorithm
- random-number generator
RANDOM(a, b)→ a ~ b 사이의 숫자를 같은 확률로 뽑기 → psedorandom-number generator : random 처럼 동작- 기본 알고리즘 : input 이 동일하면 output 이 동일
- randomized 알고리즘 : 같은 input 이어도 내부적으로 random 하게 동작 → output 이 다
⇒ 평균적으로 worst case 보다 좋음
- 내부적으로 randomize 하기에 입력값 중요 X
- 무작위 알고리즘으로 얻은 실행 시간 → expected time cost
- ex) Hiring Problem
RANDOMIZED_HIRE_ASSISTANT(n) {
	randomly permute the list of candidate // 랜덤하게 바꾸기
	HIRE_ASSISTANT(n)
}
- expected hiring cost → O(c_h \ln n)
- worst 가 들어오든 best 가 들어오든 이 정도의 성능 기대
◆ Randomly Permuting an Array
- random 이 어떻게 보장되는가?
RANDOMLY_PERMUTE(arr A, size n) {
	for i = 1 ~ n
		A[i] <-> A[RANDOM(i, n)]
}
→ 실행 시간 O(n)
- random 하다는 것 증명? → 루프 불변성
- 루프 불변성 (Loop Invariant) : i 번째 실행 시, 1 ~ i-1 까지 \frac{(n-i+1)!}{n!} 의 확률 만큼으로 unifomr 하게 생성됨.
- Before (Initialization) : 루프 시작 시
- i = 1 이므로, \frac{n!}{n!} = 1
- 공집합일 확률이 1
- After (Maintenance) : 루프 도중
- 수학적 귀납법 이용 → i-1 까지는 random 하다고 가정, i 일 때 random 하다는 것 증명하기
-
\langle x_1, x_2, … x_i \rangle → 1 ~ i 까지 순열 \langle x_1, x_2, … x_{i-1} \rangle + x_i → 1 ~ i-1 까지 선택 ∩ i 를 선택
- 1 ~ i-1 까지 선택될 확률 = \frac{(n-i+1)!}{n!} → loop invariant 에 의해 정의
- i 를 선택할 확률 = \frac{1}{n-i+1}
- 두 사건이 동시에 일어날 확률 → 곱하기
= \frac{(n-i)!}{n!}
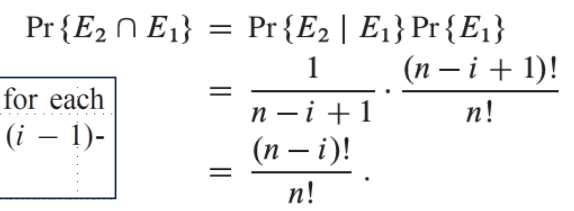
- When (Termination) : 루프 끝날 때
- i = n + 1 이므로, \frac{(n-n)!}{n!} = \frac{1}{n!}
- 전체 순열에서 하나 나올 가능성
- Before (Initialization) : 루프 시작 시
공유하기
Twitter Facebook LinkedIn글 이동
시리즈 이동
Comments