[Algorithm] Hash Tables
'알고리즘 설계와 분석' 시리즈
◆ Overview
- Dictionary 문제
INSERT,SEARCH,DELETEoperation
- hash table : 배열 장점 + linked list 장점
- 메모리를 효율적으로 사용
SEARCHexpected time : O(1) → 단 worst-case 는 \Theta(n) (linked list 기반)- array 의 일반화된 형태 → direct addressing 으로 확장
- 배울 내용
- hash functions : 데이터의 key 값이 들어왔을 때 table 에 어떻게 mapping 할 것인가?
- 충돌 발생 시 해결법
- chaining
- open addressing
✦ Hash Table
◆ Direct-address Table
- array 와 유사
- dynamic set 저장 → 원소들이 동적으로 변할 수 있는 집합
- 조건 : key 가 {0 ~ m-1} 까지. m 이 너무 크면 안 됨. 모든 key 값은 unique
-
Table 구조
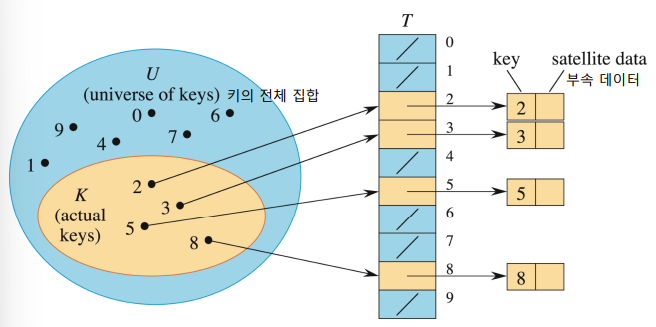
- U (universe of keys) : key 의 전체 집합
- K (actual keys) : 실제로 사용되는 key 의 집합
- T (table) : key & data 가 저장되는 table
- 가능한 모든 key 를 저장할 수 있도록 공간 만들기
- key = index 역할 → key 로 데이터 관리
- 한계 : U 와 T 가 같은 비율 → U 가 크면 T 도 매우 큰 사이즈 필요
Insertion
DIRECT_ADDRESS_INSERT(T, x)
	T[x.key] = x
Search
DIRECT_ADDRESS_SEARCH(T, k)
	return T[k]
Deletion
DIRECT_ADDRESS_DELETE(T, x)
	T[x.key] = NIL
◆ Hash Table
- U 에 비해 K 가 작을 때 Direct-address Table 사용 → T 의 공간 낭비 ↑
- h (hash function) 사용해서 mapping
- key k 가 주어졌을 때, h(k) 를 T 에 index 로 사용
- h : U → {0, 1, …, m-1}
⚠️ Collision
2 개 이상의 다른 key 가 같은 slot 에 mapping 되었을 때
- |K| ≤ m → collision 발생 할 수도, 안할 수도 ex) 방이 10개인데 사람이 2명
-
|K| > m → collision 반드시 발생 ex) 방이 10개인데 사람이 11명 → 해결 방법
- by hash function
- by chaining / open addressing
✦ Hash Function
- 무엇이 좋은 hash function 인가?
- Independent uniform hashing : 독립 균등 해시 함수 → 이상적인 hash function
- Independent : key 끼리 서로 관련 X
- uniform : 어떤 key 가 각 slot 으로 hashing 될 확률이 모두 \frac{1}{m}
- key 가 들어왔을 때 균등하게 나누기
- ex) key 가 [0, 1) 사이 실수로 가정
→ 적합한 hash function : h(k) = \lfloor km \rfloor → bucket sort
- key 값에 slot 갯수 곱하고 내림하기
- key 는 반드시 숫자가 아니어도 됨 → 그러나 음수가 아닌 정수라고 가정.
◆ Static Hashing
Division Method
- 나머지 연산자 (mod) 이용
$$
h(k) = k \ \text{mod} \ m
$$
ex) m = 20, k = 91 → h(k) = 11
- 장점 : 빠르고 쉬움
- 좋은 m (slot 갯수) ? → 2의 배수에 너무 가깝지 않은 소수
Multiplication
- bucket sorting 방법
- 임의의 A (0 ~ 1 사이 실수) 를 곱한 값의 소수부를 hash 로 사용
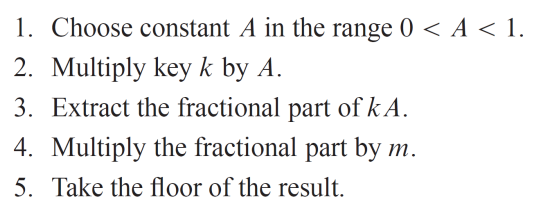
- 임의의 A (0 ~ 1 사이 실수) 를 곱한 값의 소수부를 hash 로 사용
$$
h(k) = \lfloor m(k A \ \text{mod} \ 1)\rfloor
$$
→ kA 의 소수부만 떼서 사용
- 단점 : division 보다 느림
- 장점 : A 와 상관 없이 m 선택 가능
◆ Random Hashing
- Static 은 방식을 알면 공격자가 악용할 가능성 有
-
Random Hashing : 단일 hash function 사용 X. 여러 hash function 중에 random 하게 선택 → Universal Hashing 사용 : key 와 무관하게 hash function 을 random 하게 사용
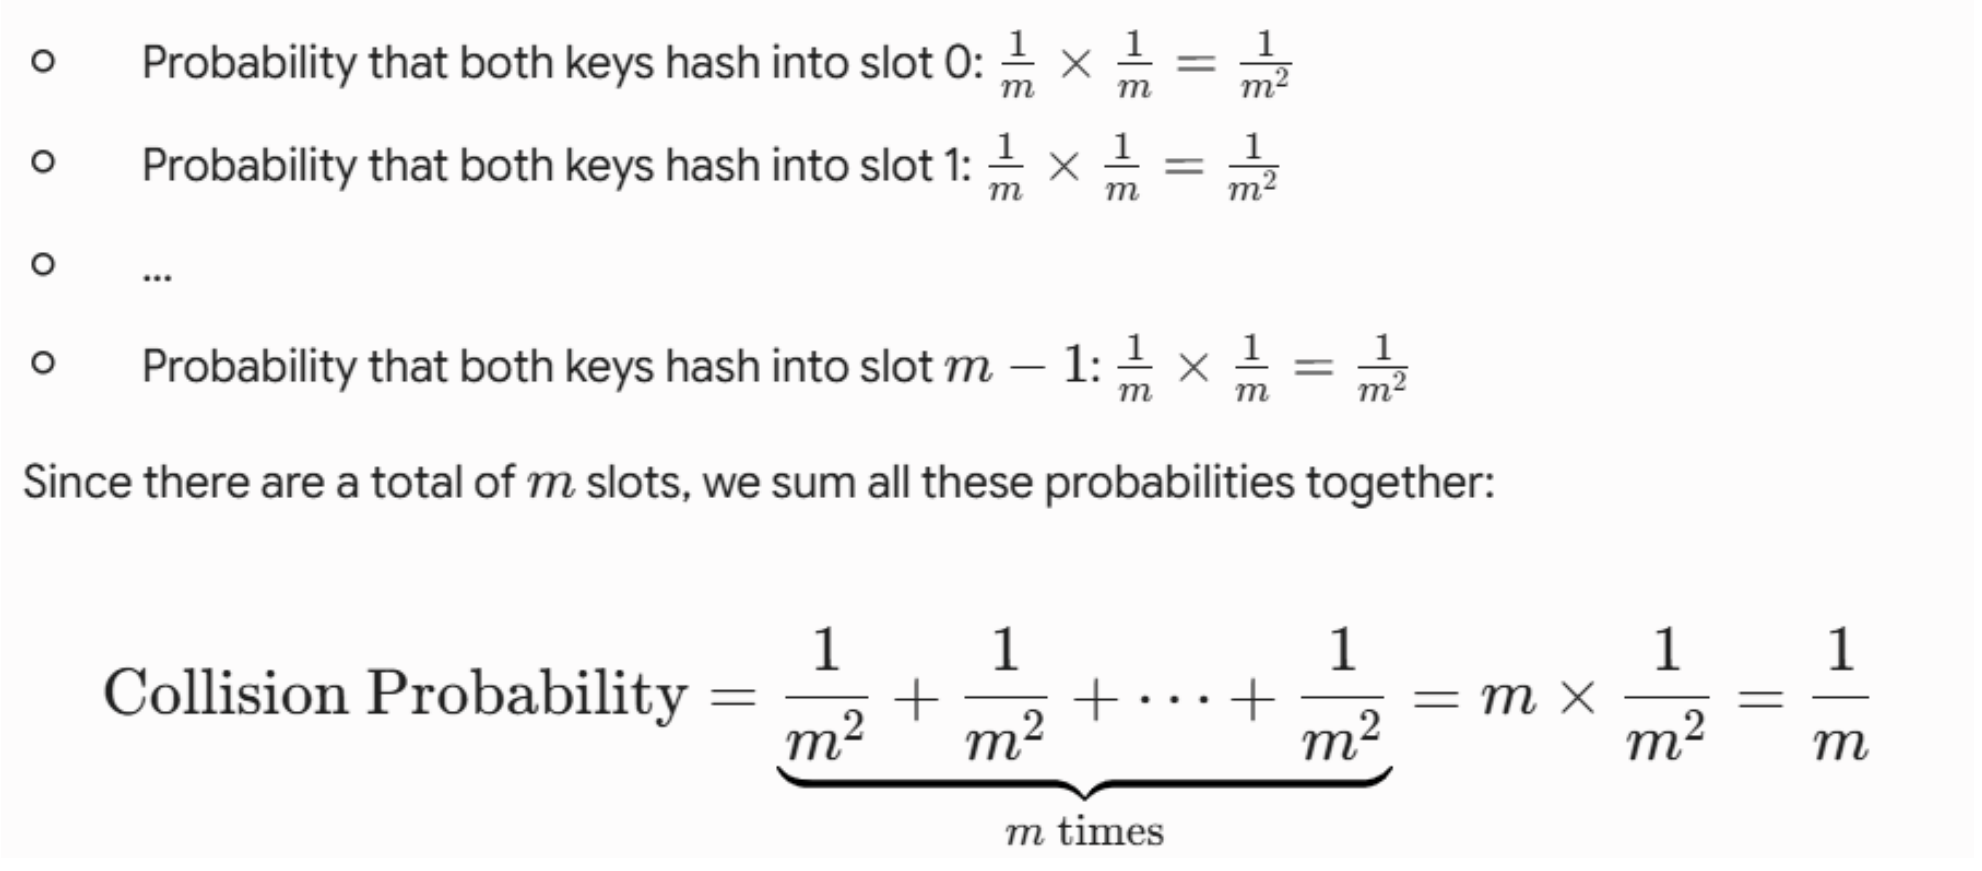
- Universal family : 임의의 두 key 충돌 확률 ≤ \frac{1}{m}
- H : 정해진 숫자 만큼의 hash function 모은 collection
-
각각의 hash function 은 서로 다른 key 값에 대해 collision 발생할 확률 ≤ \frac{ H }{m} - independent 하게 동작한다는 가정 하에
-
- H : 정해진 숫자 만큼의 hash function 모은 collection
Properties
- Uniform : 무작위로 뽑은 h 가 임의의 k (key) 를 임의의 q (slot) 으로 보낼 확률 = \frac{1}{m}
- Universal : 서로 다른 두 key 가 무작위로 뽑은 h 에서 충돌할 확률 ≤ \frac{1}{m}
- ε-universal : 충돌 확률이 ε 이하
- d-independent : 서로 다른 키 d 개가 무작위로 뽑은 h 로 모두 같은 slot 에 들어갈 확률 = \frac{1}{m^d}
A Universal Familiy of Hash Functions Based on Number Theory
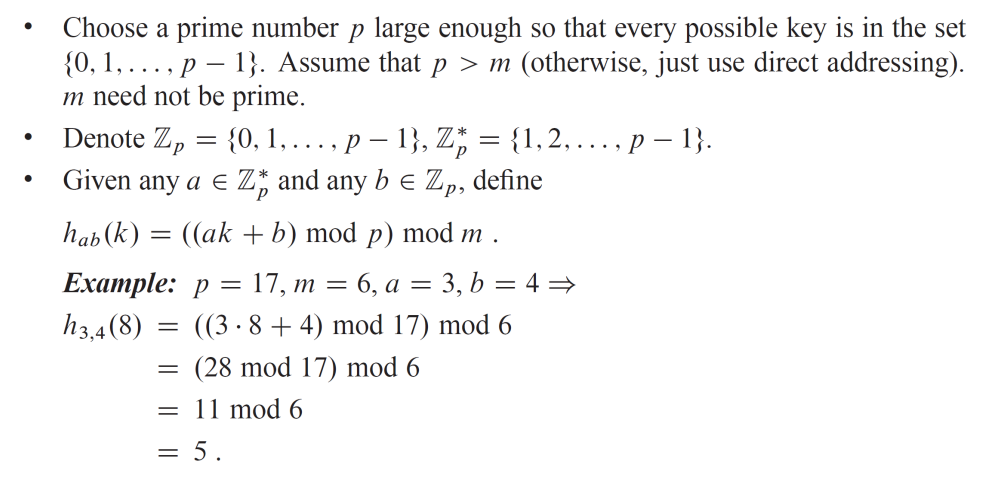
- Universal 한 hash function collection 만들기
- 충분히 큰 소수 p 선택. key 값은 {0 ~ p-1} 사이
- Z_p → {0 ~ p-1} / Z_p^* → {1 ~ p-1}
- h_{ab}(k) = ((ak+b)\mod p) \mod m
- a 는 Z_p^* 에서, b 는 Z_p 에서 아무거나 하나
- a, b 를 교체할 수 있음 → family
✦ Collision Resolution
◆ Linked List
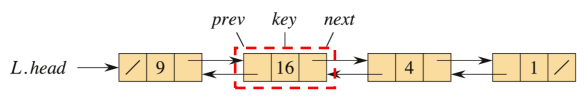
- Double linked list : prev & next 둘다 가지고 있는 linked list
- 탐색 위해선 head 알아야 함
- Insertion
LIST_PREPEND(arr L, node x) // 맨 앞으로 넣기
	x.next = L.head
	x.prev = NIL
	if L.head != NIL
		L.head.prev = x
	L.head = x
- Search
LIST_SEARCH(arr L, key k)
	x = L.head
	while x != NIL && x.key != k
		x = x.next
	return x
- Deletion
LIST_DELETE(arr L, node x) // node x 를 없애기
	if x.prev != NIL // 맨 앞이 아니면
		x.prev.next = x.next
	else L.head = x.next // 맨 앞이면
	if x.next != NIL // 맨 끝이 아니면
		x.next.prev = x.prev
◆ Chaining
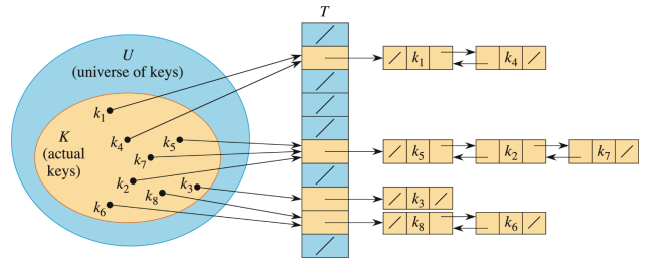
- table 의 각 slot 이 list 의 head 역할
Insertion
CHAINED_HASH_INSERT(table T, node x)
	LIST_PREPEND(T[h(x.key)], x)
Search
CHAINED_HASH_SEARCH(table T, node k)
	return LIST_SEARCH(T[h(k)], k)
Deletion
CHAINED_HASH_DELETE(table T, node x)
	LIST_DELETE(T[h(x.key)], x)
성능 분석
- Insertion & Deletion → 같은 구조. worst case O(1)
- Search 의 비용 → 각 linked list 의 길이 따라서 달라짐 h(k)
- load factor (적재율) α : list 하나 당 평균 원소 갯수
- \alpha = \frac{n}{m}
- n = table 에 저장된 총 원소 갯수
- m = slot (= linked list) 의 갯수
- α > 1, α = 1, α < 1 모두 가능
- \alpha = \frac{n}{m}
- worst case : 모든 element 가 같은 slot 으로 → \Theta(n)
- average case : hash function 이 key 를 어떻게 분포 시키는가?
- 가정 : Independent uniform hashing
-
hashing fucntion 은 universal → 두 개의 key 가 충돌할 확률 = \frac{1}{m}
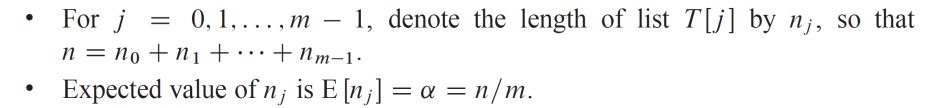
- slot j 의 list T[j] 의 길이 → n_j
- 각 list 길이의 기댓값 → E[n_j] = \alpha = \frac{n}{m}
-
- Case 1) Unsuccessful Search (탐색 실패)
- 탐색을 위해 list 전체를 살펴봐야 함
- E[n_{h(k)}] = \alpha
- linked list 의 head 찾기 + linked list 탐색하기
-
Case 2) Successful Search (탐색 성공) → Unsuccessful 과 동일
- 탐색 성공은 탐색 실패와 같되, 실제 원소를 찾는 순간 멈출 수 있다는 점만 다름 → 두 경우 모두 점근적으로 \Theta(1 + \alpha) (상수 배는 흡수)
- slot 수 (m) 를 원소 수 (n) 과 비례하기 유지하면, 즉, n = O(m) 이 되도록 관리하면
- 가정 : Independent uniform hashing
- load factor (적재율) α : list 하나 당 평균 원소 갯수
$$
\alpha = \frac{n}{m} = \frac{O(m)}{m} = O(1)
$$
→ 즉 SEARCH average time cost 가 \Theta(1) 이 됨.
◆ Open Addressing
-
Idea : 추가적인 linked list 대신 hash table 로 해결
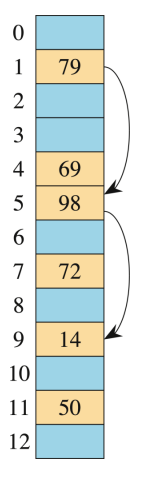
- How? → load factor \alpha 가 1이 넘지 않도록
→ 사람이 방 수를 넘지 않도록
- 70% 정도 full → 2배 큰 table 만들어서 기존 table 복사
- 이미 공간이 full → 다음 빈 곳 찾아서 jump
- 빈 곳 찾기? → Probe
- How? → load factor \alpha 가 1이 넘지 않도록
→ 사람이 방 수를 넘지 않도록
Insertion
HASH_INSERT(table T, k)
	i = 0 // probe sequence
	repeat
		q = h(k, i)
		if T[q] == NIL // 빈 곳 있음
			T[q] = k // 넣기
			return q // 넣은 index 반환
		else i = i + 1 // 빈 곳 없으면 probe + 1 하면서 빈 곳 찾기
	until i == m // probe 끝 도달
	error "hash table overflow"
Search
HASH_SEARCH(table T, k)
	i = 0 // probe sequence
	repeat
		q = h(k, i)  // 몇 번째 probe?
		if T[q] == k // 찾음
			return q
		i = i + 1    // probe + 1 하면서 찾기
	until T[q] == NIL || i == m // 빈 곳 찾음 or probe 끝 도달
	return NIL // 못 찾음
- insert 한 순서대로 찾기
- index 로 h(k) 사용 (i 는 몇 번째 probe 인지 나타냄)
- 값이 존재
- 찾는 값
k와 일치 → search 성공 - 찾는 값과 일치 X → 다음 probe 찾기
- 찾는 값
- 값이
NIL- search 실패
Deletion
- 지우면 special value
DELETED로 마킹SEARCH→ 값이 존재한다고 판단. 다음 probe 로 이동INSERT→ 값이 비었다고 판단. 값 채우기
- 단점 : load factor α 가 정확한 값 X (
DELETED는 있는? 없는?)
◆ How to Compute Probe Sequences
- 이상적인 상황 : Independent uniform permutation hashing (uniform hashing)
- 각 key 는 m! 가지 순열 중 어떤 것이든 자신의 probe sequence 로 가질 확률이 모두 균등 → \frac{1}{m!} 확률
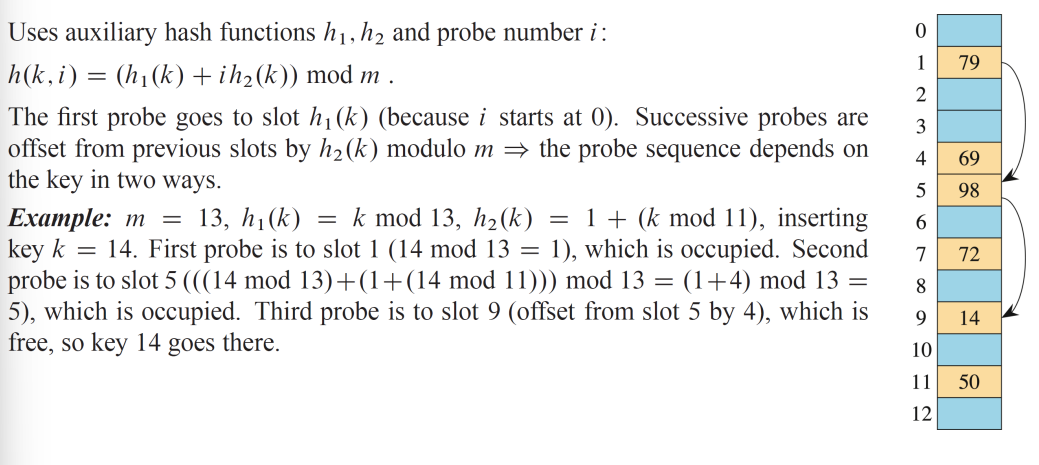
- Double Hashing
$$
h(k, i) = (h_1(k) + ih_2(k)) \mod m
$$
- hashing 을 2번 → h_1 & h_2 사용.
- h_1 → 시작 위치
- h_2 에는 i (probe 횟수) 곱해서 점점 멀리 jump 하도록 → step size
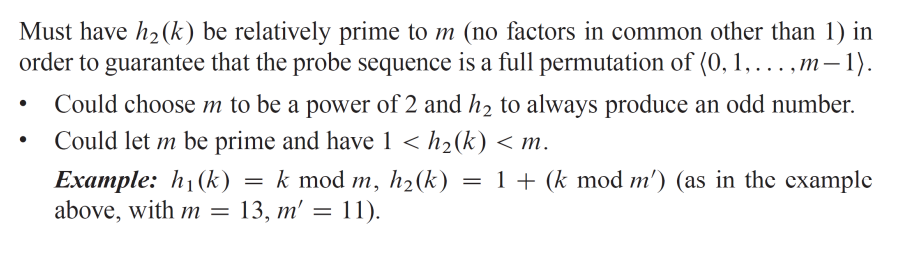
- 제약 : h_2(k) 와 m 은 서로소 (relatively prime) 이어야 함 & h_2 < m
- m 은 2의 제곱수, h_2 는 홀수 고르기
- 가능한 sequence 갯수 → m^2 가지 (시작 위치 × 점프 간격)
-
Linear Probing
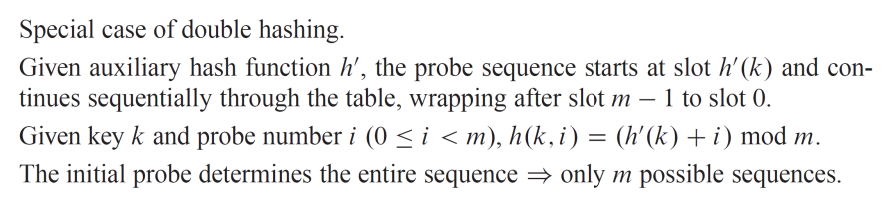
- 첫 위치 부터 1 씩 증가시켜가면서 확인.
- 총 m-1 확인
- 몇 개의 probe sequence 가능?
→ 시작 위치가 m 개 이므로 m 개 가능
- 초기 위치가 정해지면 probe 전체가 결정
공유하기
Twitter Facebook LinkedIn글 이동
시리즈 이동
Comments