[Algorithm] Sorting in Linear Time Medians and Order Statistics
'알고리즘 설계와 분석' 시리즈
- [Algorithm] Introduction
- [Algorithm] Divide-and-Conquer
- [Algorithm] Probabilistic Analysis and Randomized Algorithms
- [Algorithm] Heapsort and Quicksort
- [Algorithm] Sorting in Linear Time Medians and Order Statistics
- [Algorithm] Hash Tables
✦ Sorting in Linear Time
◆ Overview
- 기본적으로 sorting 하기 위해선 비교 (Comparision) 이 필요함.
- 지금까지 배운 insertion, merge, heap, quick sort 모두 비교 O
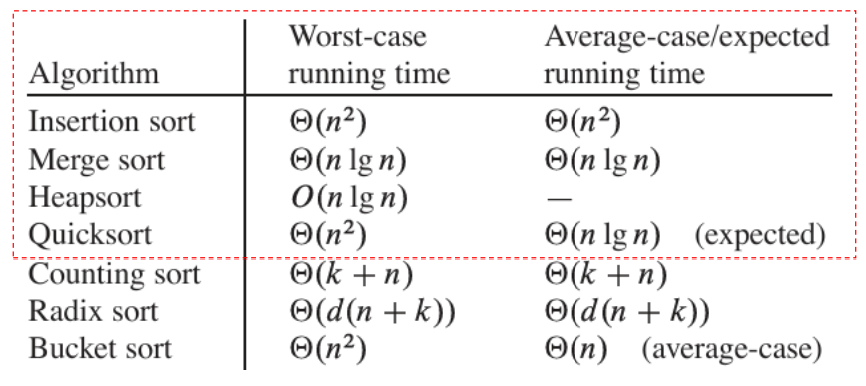
- 지금까지 배운 insertion, merge, heap, quick sort 모두 비교 O
- 비교를 해야할 때는 \Theta(n \lg n) 이 최선이다
- 나머지 세 가지 sort (Counting, Radix, Bucket) 는 추가적인 조건이 필요하다 → 이 세 가지는 비교 X
◆ Lower Bounds for Sorting
- 지금까지 모든 sort 의 하한이 \Omega(n \lg n)
- why?
Proof by Decision Tree
- Desicion Tree : 경우를 보여주는 tree
- 어떤 특정 input 이 주어지면 tree 그릴 수 있음
- 입력에 따라 tree 에서 가는 길이 달라짐
- worst case = root - leaf 까지 가장 긴 경로 길이 = height
- leaf 의 갯수 → ≥ n! 만큼 존재 (> 는 중복이 생겼을 경우)
-
insertion sort : size 가 3 인 경우
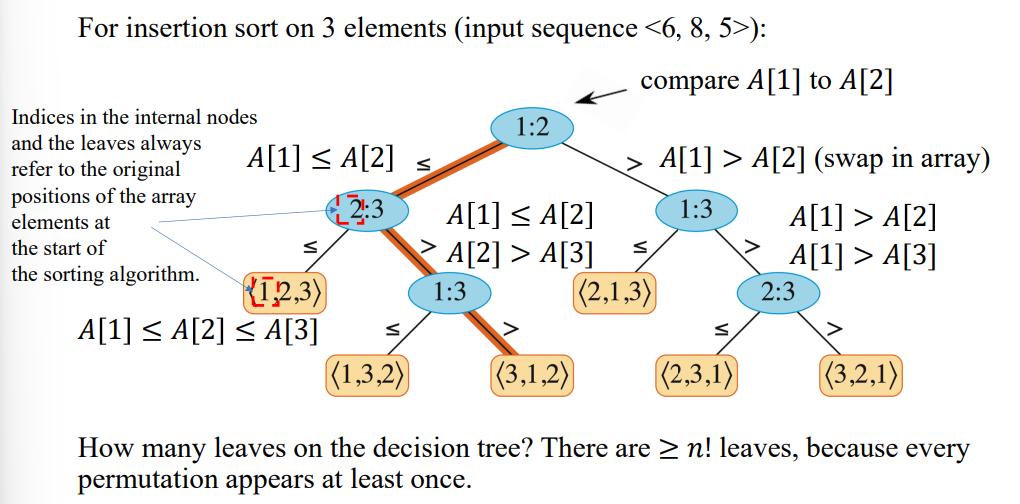
- 각 노드는 원래 배열의 index 를 기준으로 두 수를 비교
- ← 방향 : swap X
- → 방향 : swap O
- leaf → sorting 의 결과 (원래 배열 index 기준)
- [6, 8, 5] 의 결과는 \langle 3, 1, 2 \rangle
- 각 노드는 원래 배열의 index 를 기준으로 두 수를 비교
-
insertions sort : size 가 4 인 경우
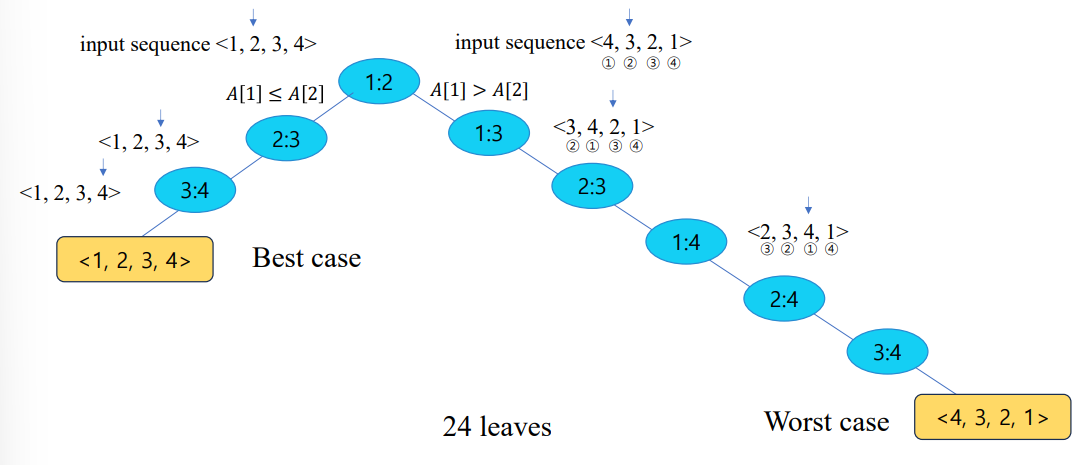
- input 이 [1, 2, 3, 4] 인 경우 → best case. swap X
- input 이 [4, 3, 2, 1] 인 경우 → worst case. 매번 swap O
- 어떤 특정 input 이 주어지면 tree 그릴 수 있음
- Lower bound for Sorting
- h : 트리의 높이
l : leaf 의 갯수
- l ≥ n! 정렬이 올바르기 위해선 모든 input 이 다른 leaf 로 가야한다. 최소 n! 개 필요
- l ≤ 2^h binary tree 에서 높이가 h 면, leaf 의 갯수는 2^h 보다 클 수 없다
- n! ≤ l ≤ 2^h 이므로 n! ≤ 2^h
- 양변에 로그 취하기. \lg (n!) ≤ h = \Omega(n \lg n) \lg(n!) = \Omega(n \lg n)
- h : 트리의 높이
l : leaf 의 갯수
◆ Counting Sort
- 조건 :
A배열의 값들이 정수 {0 ~ k} 사이의 값일 때 - Input :
A[1 ~ n]까지가 모두 0 ~ k 중의 하나의 값을 가짐 - Output :
B[1 ~ n]→ 별도의 공간 사용 - Auxiliary storage :
C[0 ~ k]→ 보조적인 추가 공간
COUNTING_SORT(arr A, size n, num k)
	arr B[1 ~ n]  // 최종 결과 저장용
	arr C[0 ~ k]  // 중간 과정
	for i = 0 ~ k
		C[i] = 0 // C 초기화
	for j = 1 ~ n
		C[A[j]] = C[A[j]] + 1 // A[j] 의 값을 C 배열에서 ++
		// C[i] 는 i 숫자가 몇 개 들어있는지 저장
	for i = 1 ~ k
		C[i] = C[i] + C[i-1]
		// C[i] 에는 0 ~ i 까지 총 몇 개의 숫자가 있는지 저장
	for j = n ~ 1
		B[C[A[j]]] = A[j] // A[j] 중에 가장 끝 위치에 A[j] 저장
		C[A[j]] = C[A[j]] - 1 // count - 1 로 업데이트. 중복값 관리
	return B
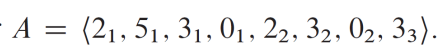
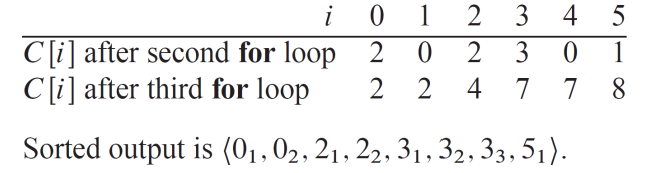
- 비교 과정 X
- 입력에서 중복되었던 순서대로 그대로 출력 → 뒤에서부터 출력했기 때문에
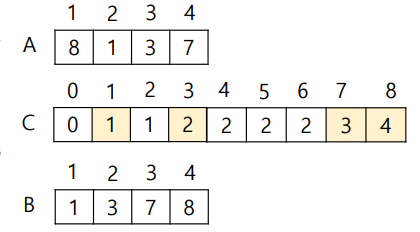
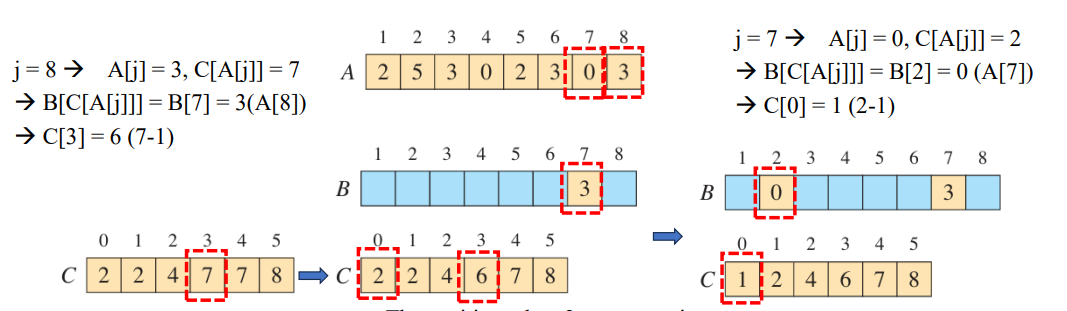
성능 분석
- k loop 2번 → \Theta(k)
- n loop 2번 → \Theta(n)
- \Theta(n + k) → 이때 k 는 정수의 범위 끝
- 만약 k 가 O(n) 정도면 → \Theta(n)
- Counting Sort 는 비교를 하지 않기 때문에 \Omega(n \lg n) 보다 낮을 수 있음
◆ Radix Sort
- 값을 index 로 쓰는 counting 정렬을 자릿수 마다 반복
RADIX_SORT(arr A, size n, bit d)
	for i = 1 ~ d
		각 bit 에 대해 A[1 ~ n] stable sort
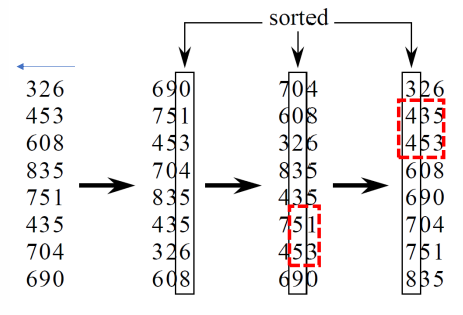
- 숫자의 각 자리 수가 지닐 수 있는 수는 0 ~ 9 까지
- 낮은 자리 수부터 각 자리에 대해 정렬 → stable sort
- 전체가 sorting 된다
정당성 증명 (Loop invariant)
- Initialization
- i = 1 일때, 최하위에 대해 정렬
- Maintenance
- 가정 : i - 1 까지 끝낸 시점에서, 올바르게 정렬되어 있음
- i 까지 정렬을 했을때
- case 1) 자리 i 의 값이 서로 다를 경우 (ex. i = 3, a = 6531 vs b = 7751)
- 이 경우에는 i 를 기준으로 정렬이 되므로 b > a 가 된다. 따라서 i 개 자릿수 기준으로 올바르게 정렬되어 있음
- case 2) 자리 i 의 값이 서로 같을 경우 (ex. i = 3, a = 6731 vs b =7751)
- 이 경우에는, i - 1 의 자리를 참고해서 정렬하는데, 이때 가정에 의해 이미 b > a 라고 정렬되어 있음.
- 따라서 자리 i 가 같든 다르든 i 자리까지 항상 정렬이 유지됨.
- case 1) 자리 i 의 값이 서로 다를 경우 (ex. i = 3, a = 6531 vs b = 7751)
- Termination
- i = d 일때, 하위 d 자리, 즉 전체 자릿수 기준으로 완전히 정렬된 상태가 됨
성능 분석
- 중간 stable sort를 counting sort 를 쓴다고 가정 → \Theta(n + k)
- stable sort 를 d번 → 총 cost \Theta(d(n+k))
- 만약 k = O(n) 이면, \Theta(dn)
- 그러나 d, k 는 고정된 값이 아님. r 을 어떻게 정하느냐에 따라 달라짐
- b = 총 bit 수 r = 묶을 bit 수
- d = \lceil\frac{b}{r}\rceil → r 이 증가할 수록 ↓ (나뉜 묶음 수)
-
k = 2^r - 1 → r 이 증가할 수록 ↑ (한 digit 이 가질 수 있는 숫자의 범위) → T(r) = \Theta(\frac{b}{r}(n + 2^r))
- ex) 32 bit 를 8 bit 씩 자르기 → b = 32, r = 8, d = 4, k = 255 (0 ~ 255)
- 최적의 r 찾기 → b 와 \lfloor \lg n \rfloor 비교하기
- b < \lfloor \lg n \rfloor → r = b 선택
- b ≥ \lfloor \lg n \rfloor → r ≈ \lg n 선택
- ex) 32 bit 숫자를 2^{16} r개 정렬 하기
- b = 32 > \lg n = 16 이므로 r = 16 설정
- \frac{b}{r} = 2 passes
◆ Bucket sort
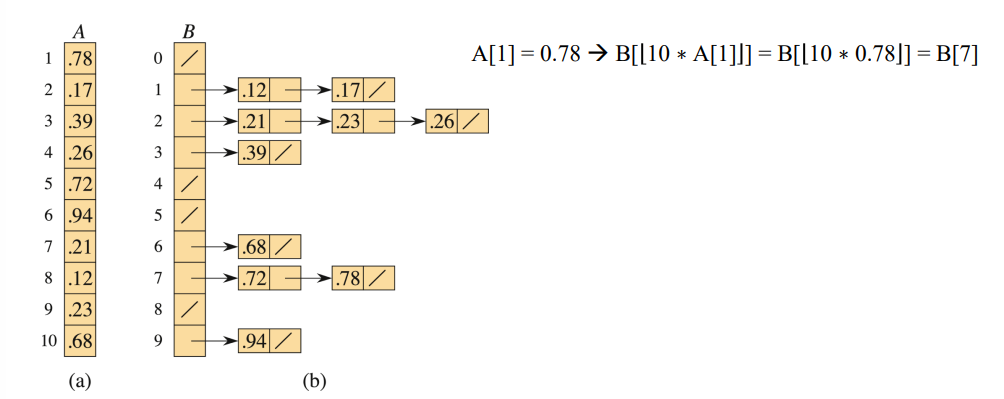
- 조건 : input 이 [0, 1) 사이에서 random 하게 생성되는 수
- Idea
- 구간을 여러 개의 동일 한 size 의 bucket 으로 쪼갬
- 각 값들을 bucket 에 넣어서 bucket 마다 sort
- 각 bucket 을 하나의 linked list 로 연결하기
- Input :
A[1 ~ n]배열, 각 값은 [0, 1) - Auxiliary array :
B[0 ~ n-1]의 linked list → Output array
BUCKET_SORT(arr A, size n)
	arr B[0 ~ n-1] = 0; // 0 으로 초기화
	for i = 1 ~ n
		insert A[i] -> B[n*A[i]] // 내림으로 (ex. 0.78 -> 7 에 저장)
	for i = 0 ~ n-1
		INSERTION_SORT(B[i])
	B[0], B[1], ... B[n-1] 까지 한 줄로 연결
return B
성능 분석
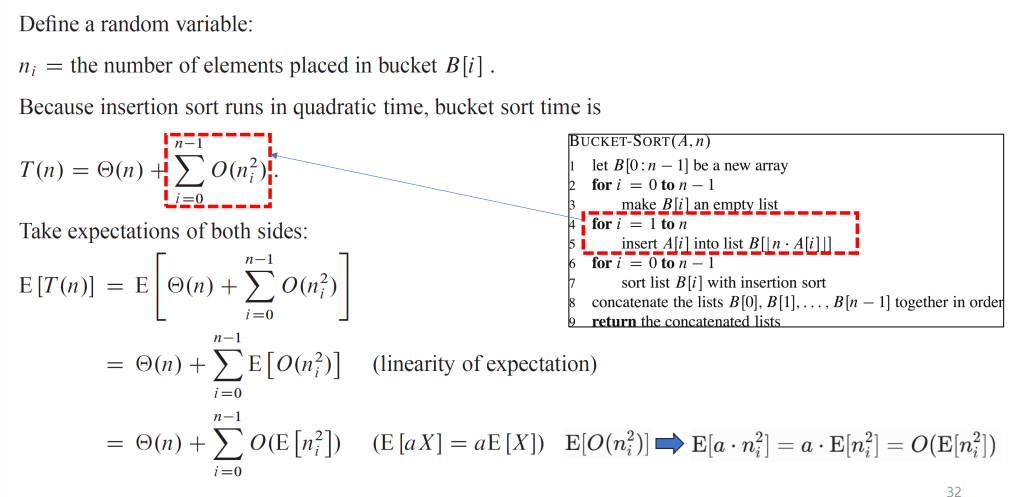
- 한 bucket 에 너무 많은 원소가 들어있지 않다는 믿음 → 입력이 [0, 1) 구간에 균등 & 독립적으로 분포한다고 가정
- 초기화 / bucket 에 넣기 / 한 줄로 만들기 → \Theta(n)
- Insertion sort 의 시간 복잡도
- 지시 확률 변수 n_i = bucket
B[i]에 들어간 element 의 갯수 -
worst case = \Theta({n_i}^2) → T(n) = \Theta(n) + \displaystyle\sum^{n-1}_{i=0}O({n_i}^2)
- n_i 는 확률 변수 이므로, 양변에 기댓값 취하기
-
E[T(n)]=Θ(n)+\displaystyle\sum^{n−1}{i=0}E[O((n_i)^2)]= Θ(n)+\displaystyle\sum^{n−1}{i=0}O(E[(n_i)^2]) n_i 를 이항 분포로 모델링 → 원소 하나가 bucket i 에 들어갈 사건
- 성공 확률 p = \frac{1}{n}
- 실패 확률 q = 1 - \frac{1}{n}
- Var[n] = E^2[n] - E[n^2]
→ E[{n_i}^2] = 2 - \frac{1}{n}
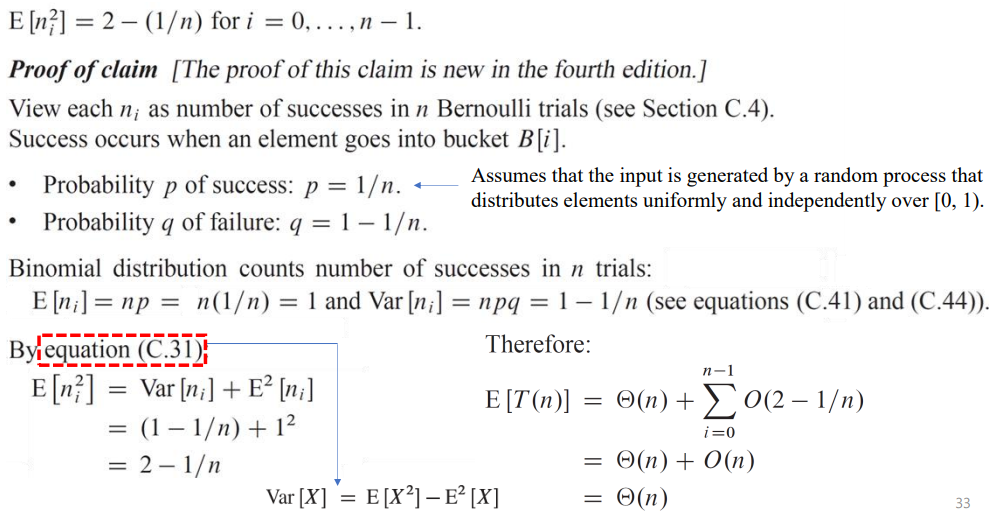
- 따라서
- 지시 확률 변수 n_i = bucket
$$
\begin{align*}\mathrm{E}\left[T(n)\right] &= \Theta(n) + \sum_{i=0}^{n-1} O\!\left(2 - \frac{1}{n}\right) \\&= \Theta(n) + O(n) \\&= \Theta(n)\end{align*}
$$
→ probabilistic analysis (단, randomized algorithm 과는 다름)
✦ Medians and Order Statistics
- 중앙값 구하기, n 번째 값 구하기
◆ Overview
- i th order statistic : 순서 통계량. i 번째로 작은 값
- minimum : 첫 번째 순서 통계량 (i = 1)
- maximum : 마지막 순서 통계량 (i = n)
- median : 가운데 순서 통계량
- 홀수 : i = \frac{n+1}{2}
- 짝수
- lower median (내림) : i = \frac{n}{2} → 일반적으로 사용
- upper median : i = \frac{n}{2} + 1
- Input : n 개의 중복되지 않는 값이 있는 set A
- Output : i 번째 작은 값 구하기
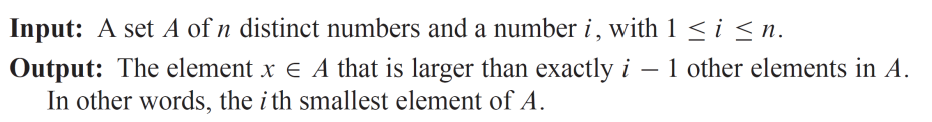
- 간단한 해결법 : sort 하고 중앙값 구하기 → 더 나은 성능의 알고리즘은 없는가?
◆ Minimum and Maximum
MINIMUM(arr[] A, size n)
	min = A[1]
	for i = 2 ~ n
		if min > A[i] // A[i] 가 더 작으면
			min = A[i]  // min 값 업데이트
	return min
→ 실행 비용 O(n)
-
maximum 도 동일
-
maximum 과 minimum 을 동시에 구할 때?
- 원래 :
MINIMUM&MAXIMUM사용 → 2n - 2번 comparision 필요 -
pair 로 묶어서 비교 → 3\lfloor\frac{n}{2}\rfloor 만으로 충분
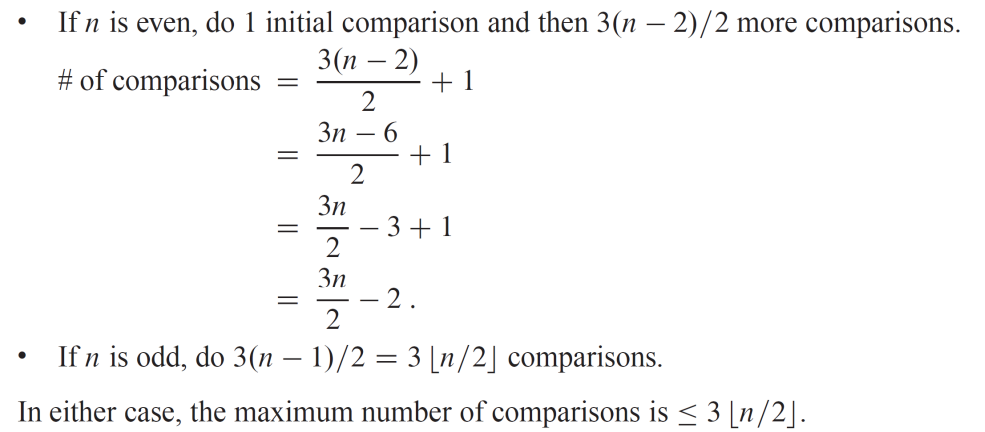
- 쌍 안의 두 원소 서로 비교 → 쌍 안에서 큰 값 / 작은 값 정해짐
- 큰 원소 vs max 비교 / 작은 원소 vs min 비교 → 비교 3번, 크기 절반으로 나누기 ⇒ 3\lfloor\frac{n}{2}\rfloor
- 원래 :
◆ Selection in Expected Linear Time
- Searching 의 성능 개선 → quicksort 의
RANDOMIZED_SELECT사용
RANDOMIZED_SELECT(arr A, start p, end r, find i)
	if p == r
		return A[p]
	q = RANDOMIZED_PARTITION(A, p, r) // random 한 pivot
	k = q - p + 1
	if i == k
		return A[q] // pivot 이 정답
	else i < k
		return RANDOMIZED_SELECT(A, p, q-1, i) // 앞쪽에서 찾기
	else return RANDOMIZED_SELECT(A, q+1, r, i-k) // 뒤쪽에서 찾기 -> i 수 줄이기
-
i 번째 작은 수를 골라야 함
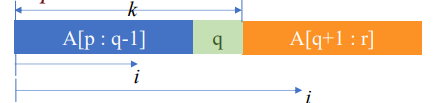
-
세 구간으로 나누기
A[p ~ q-1]→ i 번째 수 찾기A[q]→ i 번째가 딱 pivot 일때A[q+1 ~ r]→ **i-k **번째 수 찾기 (앞쪽 값 찾은 만큼 빼주기)
성능 분석
- worst case : \Theta(n^2) → quicksort 의 worst case. pivot 이 한쪽에만 몰림
-
expected case : 극단적이지 않을 것이라고 기대
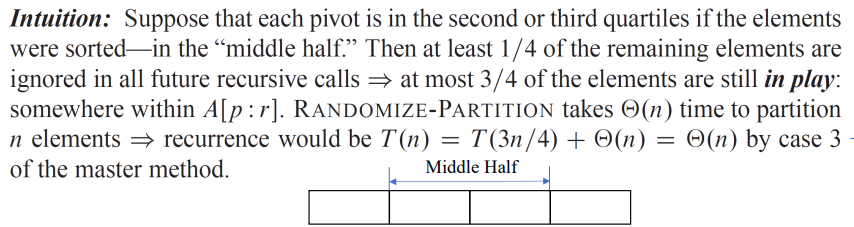
- Intuition : 구간을 4개로 나눈다고 생각. pivot 이 가운데 쪽에 있을 가능성이 높음. 1/4 정도가 버려지고 3/4 정도가 남아있음
-
점화식 : T(n) = T(3n/4) + \Theta(n) → Master Theorem Case 3) \Theta(n)
-
Expected time = \Theta(n)
-
- Intuition : 구간을 4개로 나눈다고 생각. pivot 이 가운데 쪽에 있을 가능성이 높음. 1/4 정도가 버려지고 3/4 정도가 남아있음
◆ Selection in Worst-case Linear Time
- worst case 에서도 O(n) 이 나올 수 있음
- random 사용하지 않고 좋은 pivot 선택하기
- 5 개씩 grouping 하고 각각 sorting → T(n/5)
- 각 group 의 중간값 (3번째) 모아서 그것들의 중위값 구하기
→ T(7n/10) (나머지 3/10 은 pivot 보다 작음 보장)
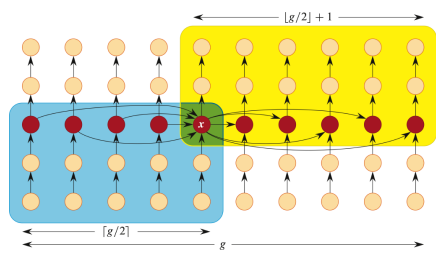
- random 사용하지 않고 좋은 pivot 선택하기
- T(n) ≤ T(n/5) + T(7n/10) + \Theta(n) → 상한이 T(n) ≤ cn
공유하기
Twitter Facebook LinkedIn글 이동
시리즈 이동
Comments