[Algorithm] Heapsort and Quicksort
'알고리즘 설계와 분석' 시리즈
✦ Sorting
◆ Overview
- Sorting 의 정의
- Input : n 개의 숫자 \langle a_1, a_2, …, a_n \rangle
- Output : 순서대로 정렬된 숫자들
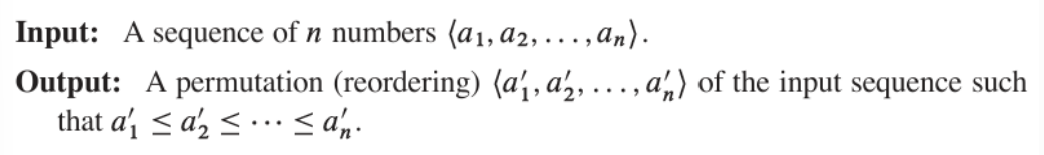
-
다양한 정렬 알고리즘 존재 → 같은 결과, 다른 시공간 사용
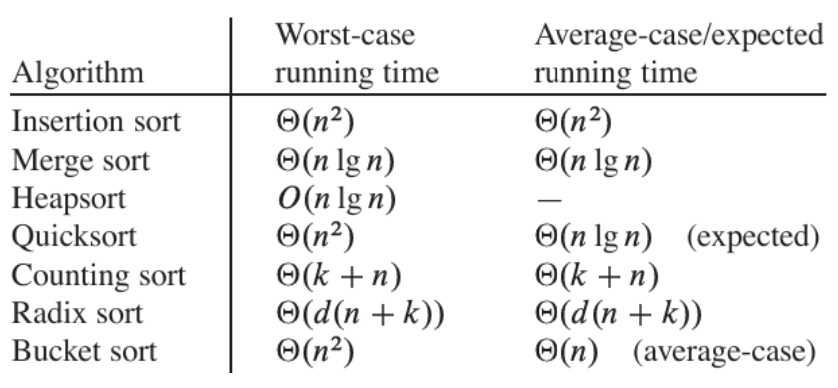
- Insertion sort : worst case 경우 \Theta(n^2), 추가 공간 사용 X
- Merge sort : 항상 \Theta(n \lg n), 추가 공간 사용 O
- expected : randomized 도입
- average : 확률 도입
✦ Heapsort
- 특징
-
worst case : O(n \lg n) → 일반적으로 정렬 알고리즘은 이보다 빨라질 수 없음
- in place (추가 저장공간 X)
- 데이터 구조를 사용해 만든 알고리즘
-
◆ Heap
- Complete binary tree
- 자식은 두 개까지 가질 수 있음
- 맨 밑 level 이외는 모두 채워져있음
- 맨 밑 level 은 → 이 방향으로 채워짐
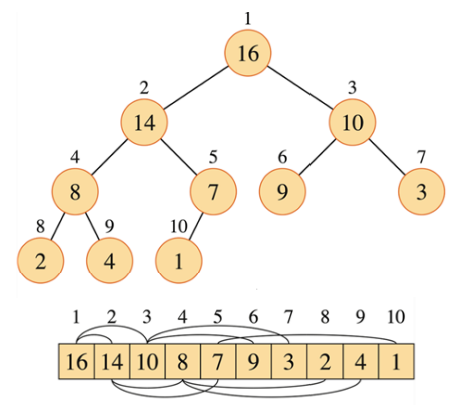
- 1차원 배열에 저장
- Root :
A[1] A[i]의 부모 :A[⌊i/2⌋]A[i]의 ← 왼쪽 자식 :A[2i]A[i]의 → 오른쪽 자식 :A[2i+1]
- Root :
PARENT(i)
	return i/2

LEFT(i)
	return 2i

RIGHT(i)
	return 2i + 1
A.heap_size: heap 의 크기- heap 의 종류
- max-heap : 부모 쪽에 높은 수
A[PARENT(i)]≥A[i]- Heap sort 에 사용
- min-heap : 부모 쪽에 낮은 수
A[PARENT(i)]≤A[i]- Priority queue 에 사용
- max-heap : 부모 쪽에 높은 수
◆ Heap Functions
MAX_HEAPIFY- 특정 위치
i에서 heap 만들기
- 특정 위치
MAX_HEAPIFY(arr A, node i) {
	l = LEFT(i)
	r = RIGHT(i)
	if l <= A.heap_size && A[l] > A[i] // Child 가 더 크면
		largest = l
	else
		largest = i
	if r <= A.heap_size && A[r] > A[largest] // Child 가 더 크면
		largest = r
	if largest != i // child 가 더 컸으면 교환
		A[i] <-> A[largest]
		MAX_HEAPIFY(A, largest) // 교환된 parent 과 그 아래 child 비교
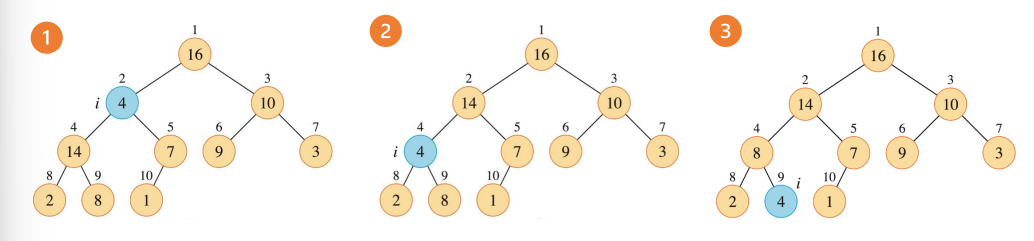
A[i]와A[LEFT(i)],A[RIGHT(i)]비교- parent 가 child 보다 작으면 교환
- 실행 시간 : O(\lg n) → tree 의 높이 (직관적)
-
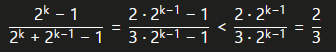
점화식 : T(n) ≤ T(\frac{2n}{3}) + \Theta(1) 가장 불균형이 심한 경우 → 마지막 레벨이 왼쪽만 채워진 상태
- 왼쪽 :
k개의 레벨이 모두 full → 2^k-1 개 node - 오른쪽 :
k-1개 레벨까지만 full → 2^{k-1} -1 개 node → 왼쪽 서브트리가 전체에서 차지하는 비율 = \frac{2}{3} 이므로 재귀가 어느쪽으로 내려가든 subtree 크기가 \frac{2n}{3} 넘지 않음
- 왼쪽 :
-
- Master Theorem 의 case 2 적용
  - a = 1, b = \frac{3}{2}
  - watereshed function : \log_ba = \log_{\frac{3}{2}}1 = 0
  - driving function : \Theta(1) = \Theta(n^{\log_ba})
  - T(n) = \Theta(n^{\log_ba} \lg n) = \Theta(\lg n) ⇒ O(\lg n) → 따라서 실행 시간 O(\lg n)
BUILD_MAX_HEAP- 아래에서부터 전체 heap 만들기
BUILD_MAX_HEAP(arr A, size n) {
	A.heap_size = n
	for i = n/2 ~ 1  // leaf node 에선 부를 필요 X
									 // internal node ~ root 까지
		MAX_HEAPIFY(A, i)
}
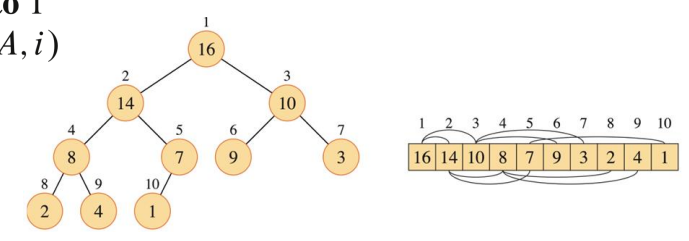
- n = 10 이므로 5, 4, 3, 2, 1 에서 `MAX_HEAPIFY` 호출 - 실행 시간
- 직관 : `MAX_HEAPIFY` O(n) 번 호출 → O(n \lg n)
- 실제 : O(n) 모든 노드가 \lg n 높이에서 `MAX-HEAPIFY` 호출하는 것 X
- 높이가 `h` 인 노드는 최대 \lceil \frac{n}{2^{h+1}} \rceil 개 존재
- 비용 = \sum 각 높이의 노드 갯수 × 그 높이에서의 비용 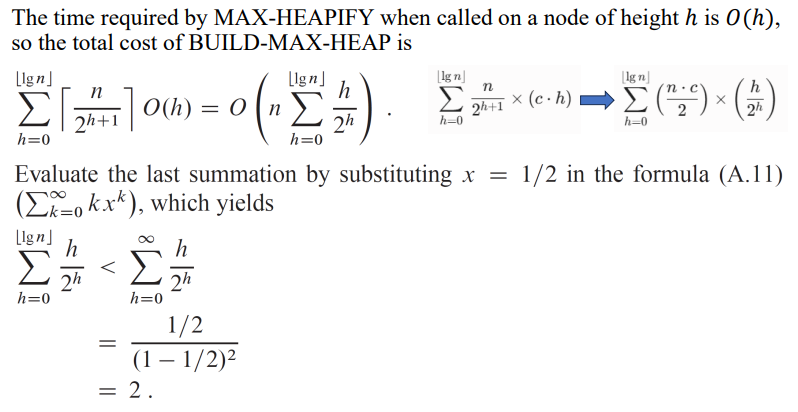
→ 급수의 값이 n 과 무관하게 상수 2 임.
HEAPSORT- array 를 max-heap 으로 만들기
- Heap 에서 root (max) 을 정렬된 배열에 옮기고 다시 heap 으로 만든다
- 2번을 반복해 정렬된 배열을 만든다
HEAPSORT(arr A, size n)
	BUILD_MAX_HEAP(A, n)
	for i = n ~ 2
		A[1] <-> A[i]
		A.heap_size--
		MAX_HEAPIFY(A, 1) // root 넘기기
- root ↔ 맨 끝 → root 는 정렬된 맨 끝으로
-
array size -1 하고 다시
HEAPIFY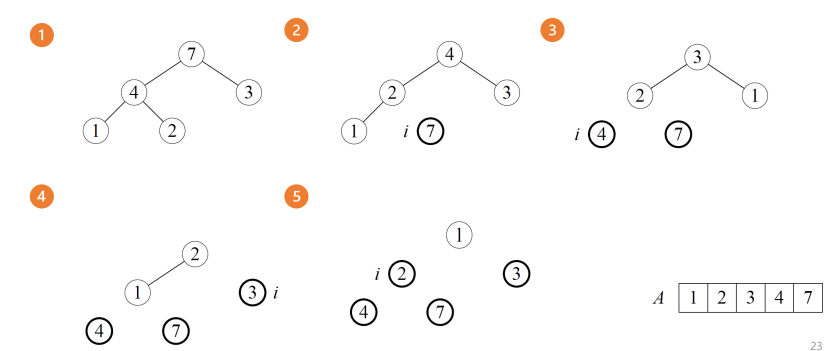
- 실행 시간
BUILD_MAX_HEAP: O(n)for: n - 1 번swap: O(1)MAX_HEAPIFY: O(\lg n) → 총 시간 : O(n \lg n)
- 높은 값 / 낮은 값 순서대로 저장하는 큐
- Min priority queue → Dijkstra 에서 사용
- 제공 operaion
INSERT(S, x, k)MAXIMUM(S)EXTRACT_MAX(S)INCREASE_KEY(S, x, k)
✦ Quicksort
- 특징
- worst case : O(n^2)
- in place (추가 저장공간 X)
- randomized 사용 알고리즘 → expected running time : \Theta(n \lg n)
◆ Quicksort
- Divide-and-Conquer 사용
A[p ~ r]정렬- Divide : 두 개의 array 로 쪼개기
A[p ~ q-1]/A[q+1 ~ r]기준 : pivotq보다 작으면 ← 이쪽 /q보다 크면 → 이쪽에 저장- 나눈 pivot
q의 위치는 고정
- 나눈 pivot
- Conquer : 두 나눈 subarray 를
QUICKSORT로 정렬 - Combine : 알아서 정렬하므로 사용 X
QUICKSORT
QUICKSORT(arr A, start p, end r) {
	if p < r
		// pivot q 기준으로 자르기
		q = PARTITION(A, p, r)
		QUICKSORT(A, p, q-1)
		QUICKSORT(A, q+1, r)
		// q 는 어디감? -> partition 위치로 잡히면 고정!
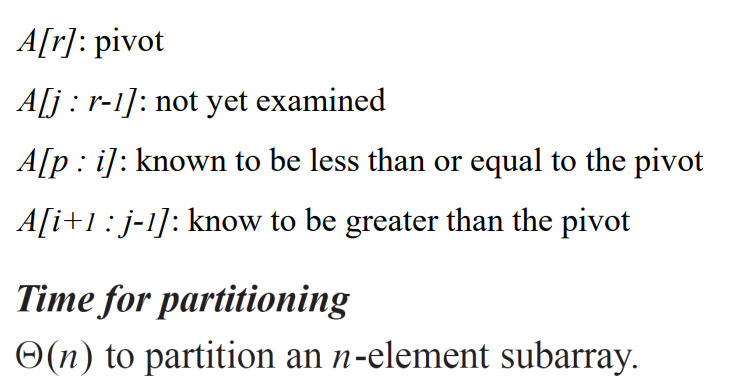
PARTITION(arr A, start p, end r) {
	x = A[r] // 맨 끝 값을 pivot 으로 설정
	i = p-1  // 2번째 값
	for j = p ~ r-1
		if A[j] <= x // pivot 보다 작으면
			i++
			A[i] <-> A[j]
	A[i+1] <-> A[r]	// pivot 기준으로 나뉘도록 이동시킴
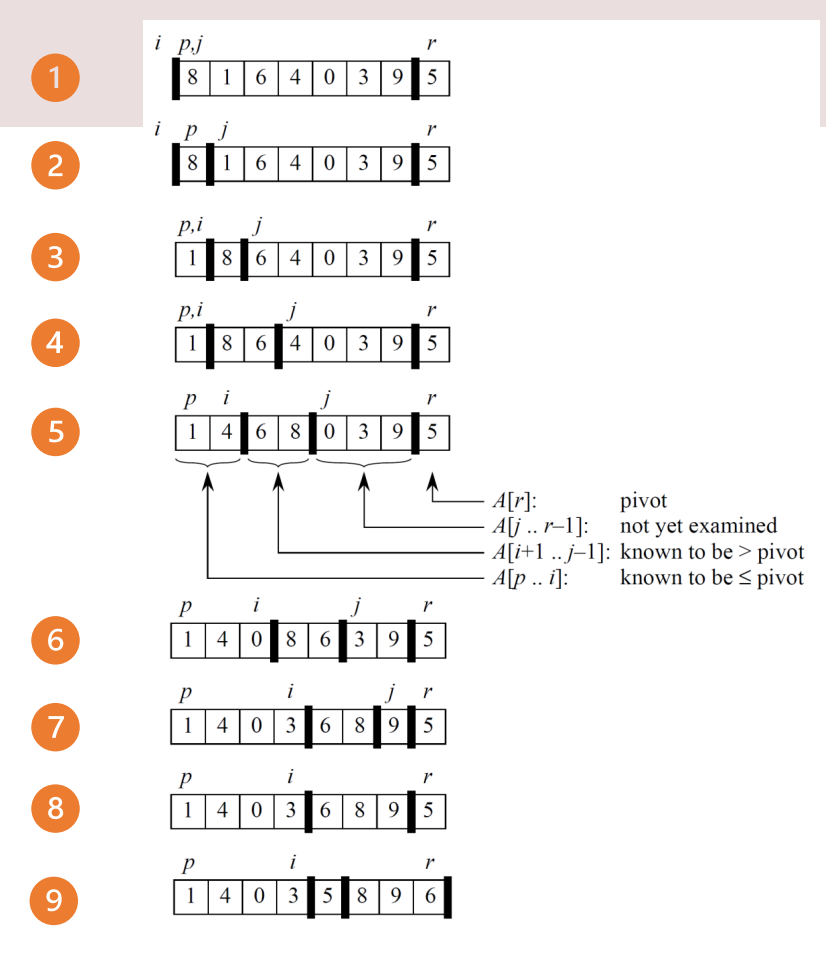
- pivot 보다 작으면 ← / pivot 보다 크면 →
- j 가 이동하면서 check
- 마지막에
i+1↔r바꿔서 pivot 이 중간으로 가도록
◆ Performance of Quicksort
-
worst case : 고른 pivot 이 제일 크거나 작을 경우 → \Theta(n^2)
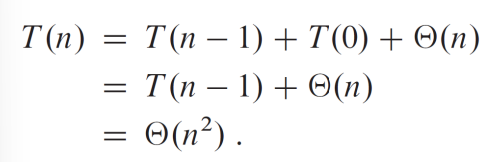
- 한 쪽에
n-1개, 다른 쪽에0개
- 한 쪽에
-
best case : pivot 이 항상 중간 → \Theta(n \lg n)
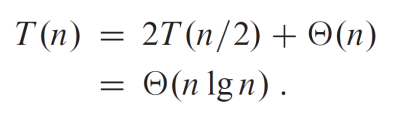
-
average case : \Theta(n\lg n)
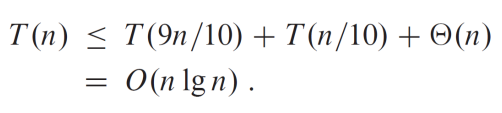
→ 똑같이 \Theta(n \lg n)
- 불균형 recursion tree
- 꽉 찬 레벨 \log_{10}n 개
- 비어있지 않은 레벨 \log_{\frac{10}{9}}n 개까지 존재 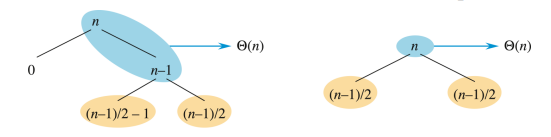
→ 똑같이 \Theta(n \lg n)
- worst case 는 best case 의 2 배의 일 더하기
- 정렬해야 할 서브배열 갯수 그대로
◆ Randomized Version of Quicksort
- randomized 추가
RANDOMIZED_PARTITION(arr A, start p, end r)
	i = RANDOM(p, r)
	A[r] <-> A[i]
	return PARTITION(A, p, r)
PARTITION(arr A, start p, end r) {
	x = A[r] // 맨 끝 값 -> pivot
	i = p-1  // 2 번째 값
	for j = p ~ r-1
		if A[j] <= x // pivot 보다 작으면
			i++
			A[i] <-> A[j]
	A[i+1] <-> A[r]	// pivot 기준으로 나뉘도록 이동시킴
- pivot 을 random 하게 설정
- 실행 시간
-
실행 비용 →
PARTITION안의for문에 영향 → 어떤 pivot 을 사용했는지 따라 비용 다름 -
O(n\lg n)
A배열에 들어 있는 값을 z_1, z_2, …, z_n 이라고 하고, 오름차순으로 정렬되어 있다고 가정- Z_{ij} = {z_i \sim z_j}
- Quicksort 에서 어떤 두 값이 비교되는 횟수는 최대 한 번이다. → 비교는 pivot 이랑만 하는데, pivot 은 한 번 설정하면 고정되므로.
- 지지 확률 변수 X_{ij} = I{z_i \text{ 가 } z_j \text{ 와 비교됨}}
- 비교 하면 1
- 언제 비교가 되는가? → 둘 중 하나라도 pivot 으로 선택되는 경우
- \frac{1}{j-i+1} + \frac{1}{j-i+1} = \frac{2}{j-i+1}
- 비교 안하면 0 → 가능한 모든 쌍
- 비교 하면 1
-
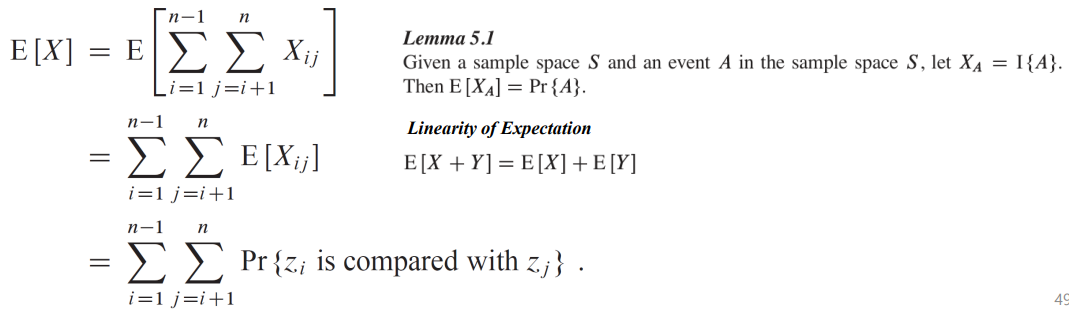
- 확률 = 기댓값이므로 → O(n\lg n) 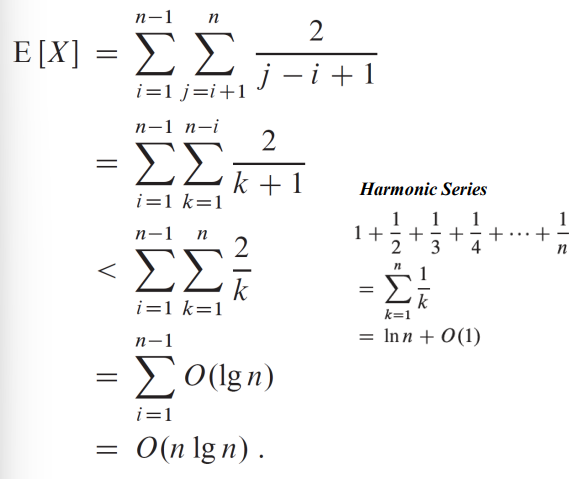
공유하기
Twitter Facebook LinkedIn글 이동
시리즈 이동
Comments