[CS] Cache Memory
'컴퓨터 시스템 개론' 시리즈
✦ Why do we need Cache
◆ Processor-Memory Gap
-
CPU 성능 상승률 »> main memory 성능 상승률
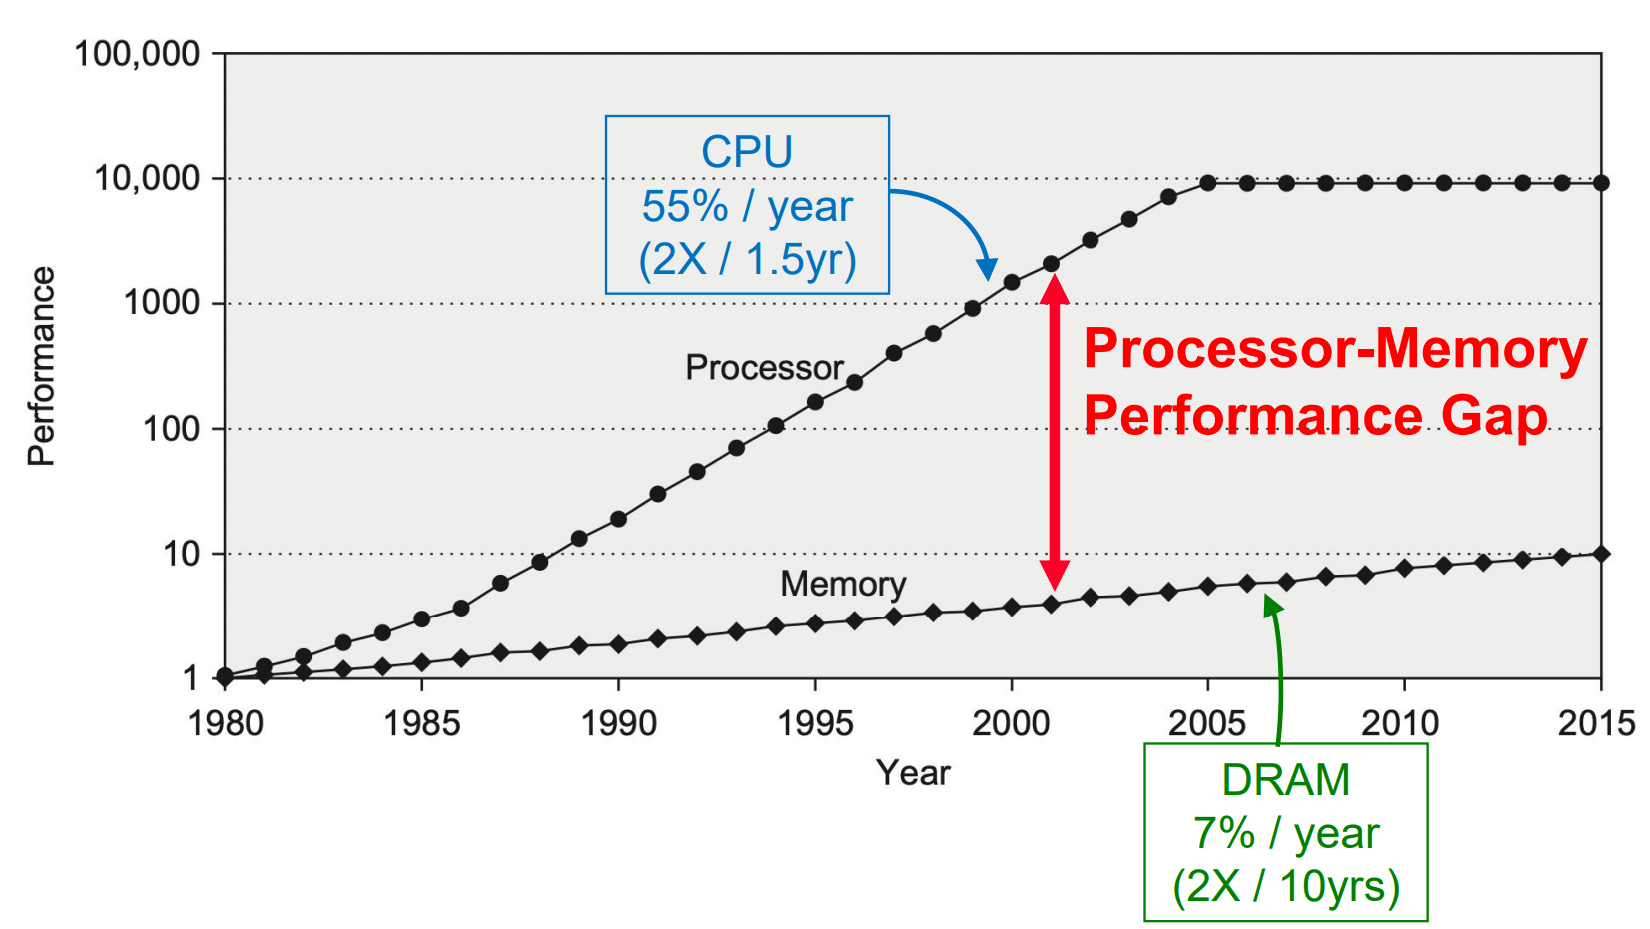
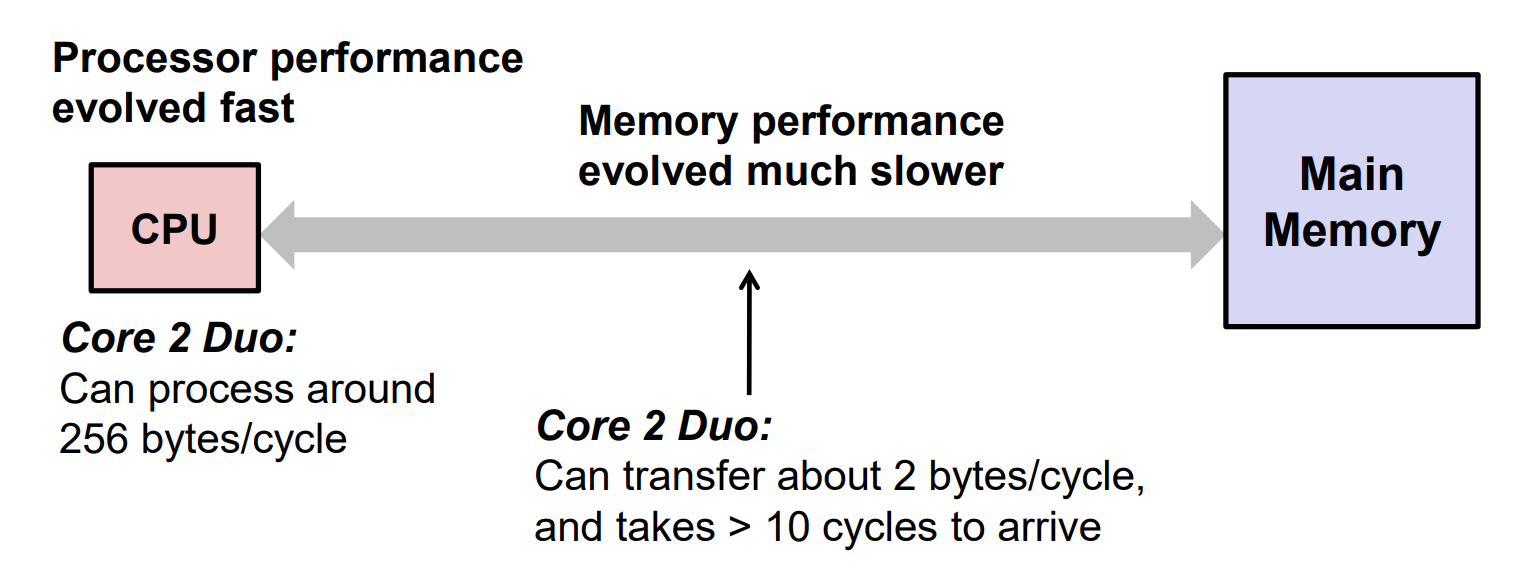
- CPU 성능 : cycle 당 어셈블리 명령어 몇 개 실행?
- memory 성능 : cycle 당 CPU 에 정보 얼마나 많이 보낼 수 있음? → CPU 쪽에서 오래 기다려야 함
-
Bottleneck (병목) 현상
-
Observation → 같거나 근처 address 에서 다시 access 가능성 높음
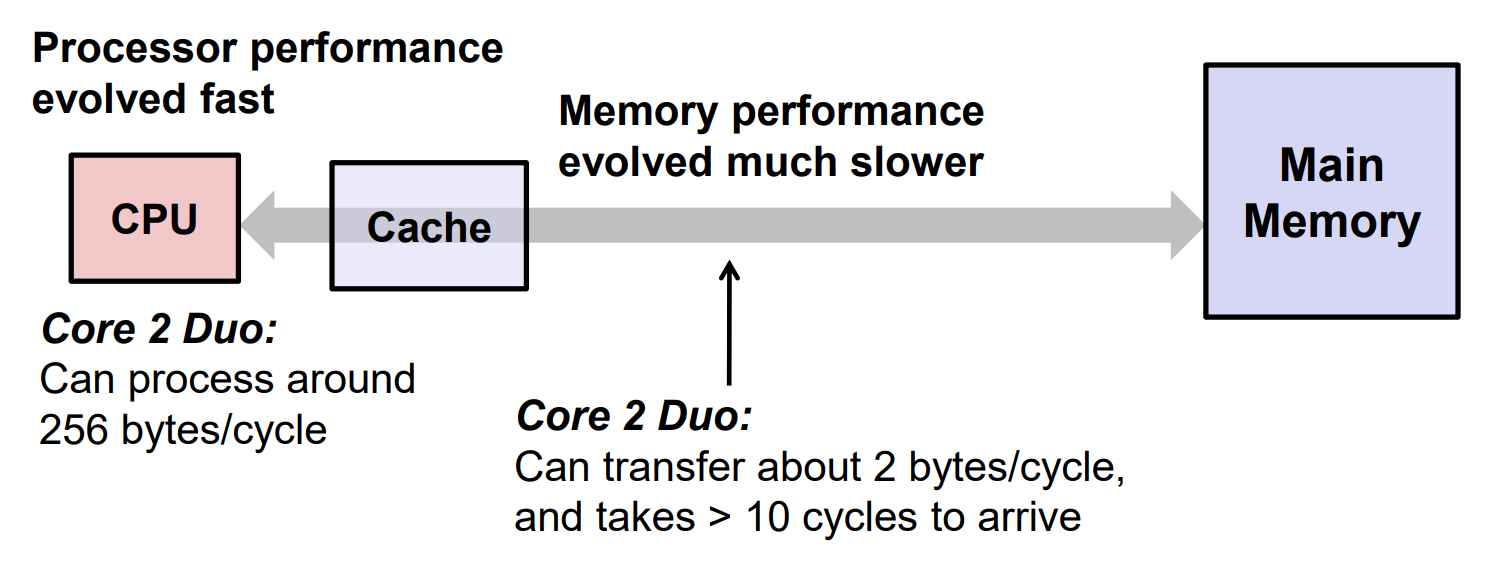
- CPU - main memory 사이 중간 저장소
- CPU 에 가까움
- 상대적으로 자주 사용하는 데이터 저장
-
✦ Basic concepts of cache memory
◆ Cache
- cash 처럼 들려서
$로 쓰기도 함 - 좁은 의미 : CPU - main memory 사이 중간 storage
- data / code 저장
- CPU 가 memory 보다 훨 빨리 접근 가능함
- 넓은 의미 : 어떤 두 시스템 사이 중간 저장소
- ex) Web browser cache
- 하드웨어 레벨에서 자동 관리
- 어셈블리 언어에서 직접적 control 불가능 → transparent
- Main memory 보다 크기 ↓, access time ↑
-
main memory 에서 자주 접근되는 일부 subset 저장 → Block (최소 단위)
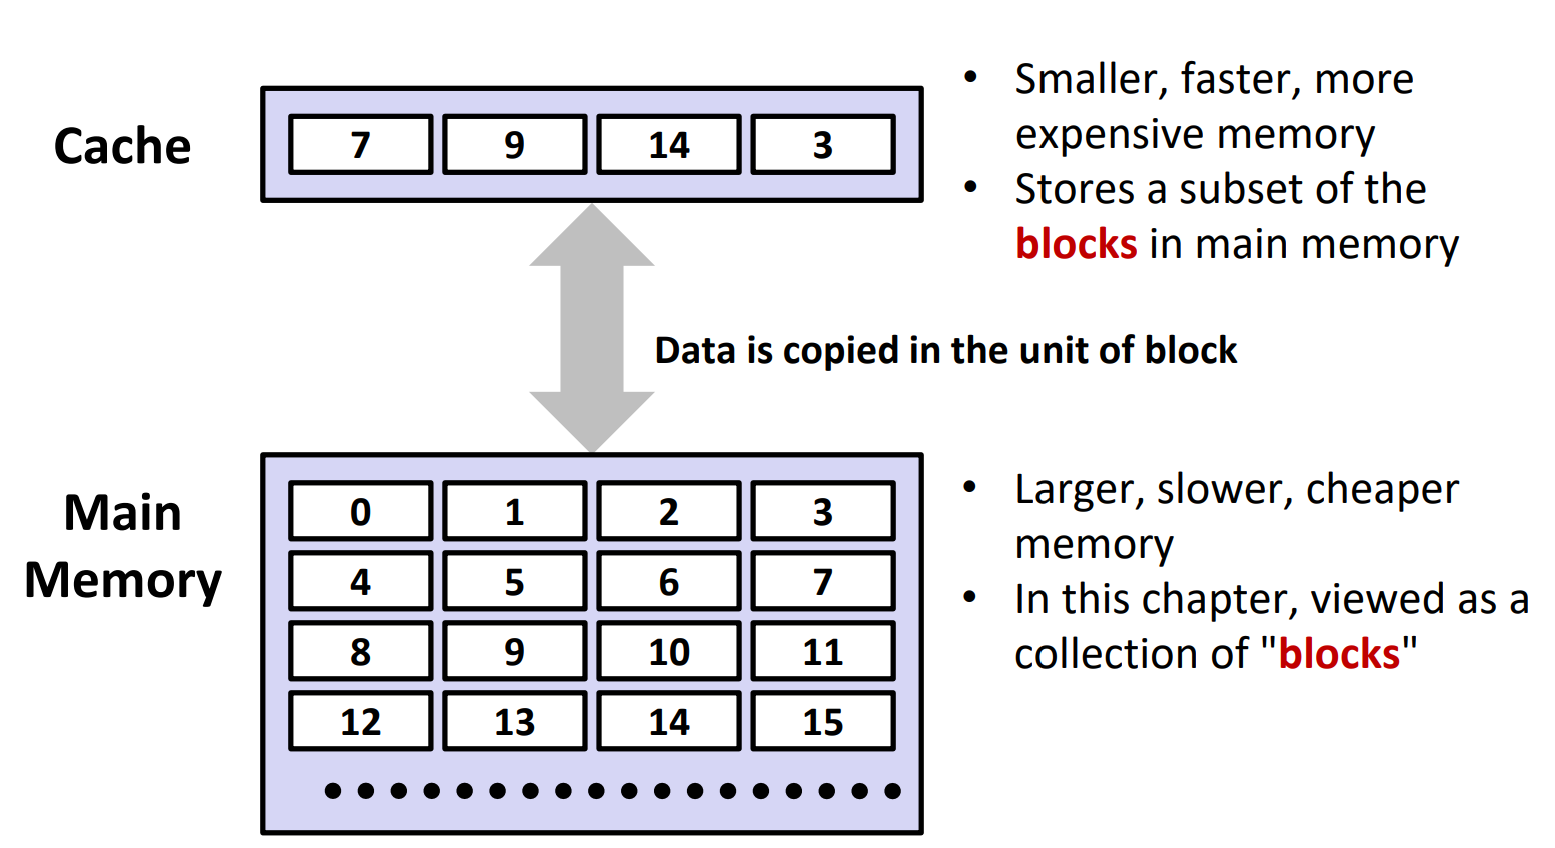
- Main Memory : 0, 1, 2, 3, …
- 연속된 64 byte collection (단위는 CPU 결정)
- 이 중 몇몇 block 이 cache 로 복사
- Cache : 7, 9, 14, 3
- Main memory 에서 특정 block 복사
-
◆ Cache hit and miss
- Cache hit : CPU 에서 필요한 data 가 cache 에 있움
- Cache miss : CPU 에서 필요한 data 가 cache 에 없음 → 기존에 있던 block replace (replacement policy)
◆ Locality
- cache 가 효율적인 이유
- Temporal Locality
- 한 번 참조된 memory 가 다시 참조될 가능성 높음
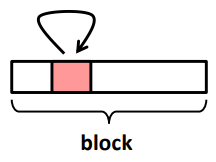
- 한 번 참조된 memory 가 다시 참조될 가능성 높음
- Spatial Locality
- 참조된 memory 근처 memory 가 참조될 가능성 높음
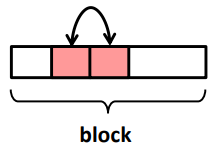
- 참조된 memory 근처 memory 가 참조될 가능성 높음
- 많은 프로그램들이 자연스럽게 이런 요소 받아들임. → cache 에 저장해 다음 접근에 더 빠르게 load 할 수 있도록 함
-
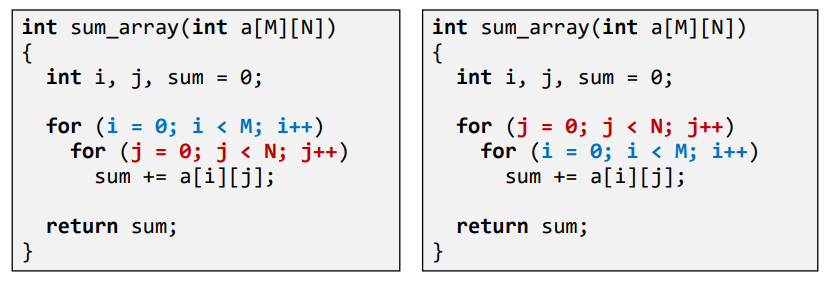
Example
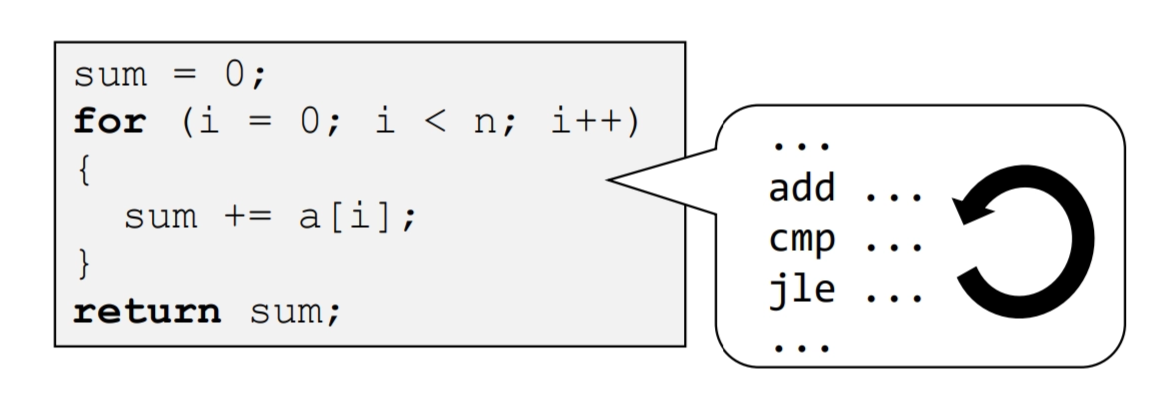
- Data 의 Locality
- Temporal :
sum변수 반복적 참조 - Spatial :
a[]의 요소들 순차적 참조
- Temporal :
- Instruction (code) 의 Locality
- Temporal :
+=연산이 loop 안에서 반복적으로 실행 - Spatial : 명령어들의 순차적으로 참조
- Temporal :
- Data 의 Locality
◆ Memory Hierarchy
- 빠른 저장공간 → 비쌈 & 크기 작음
-
크기 큰 저장공간 → 쌈 & 느림
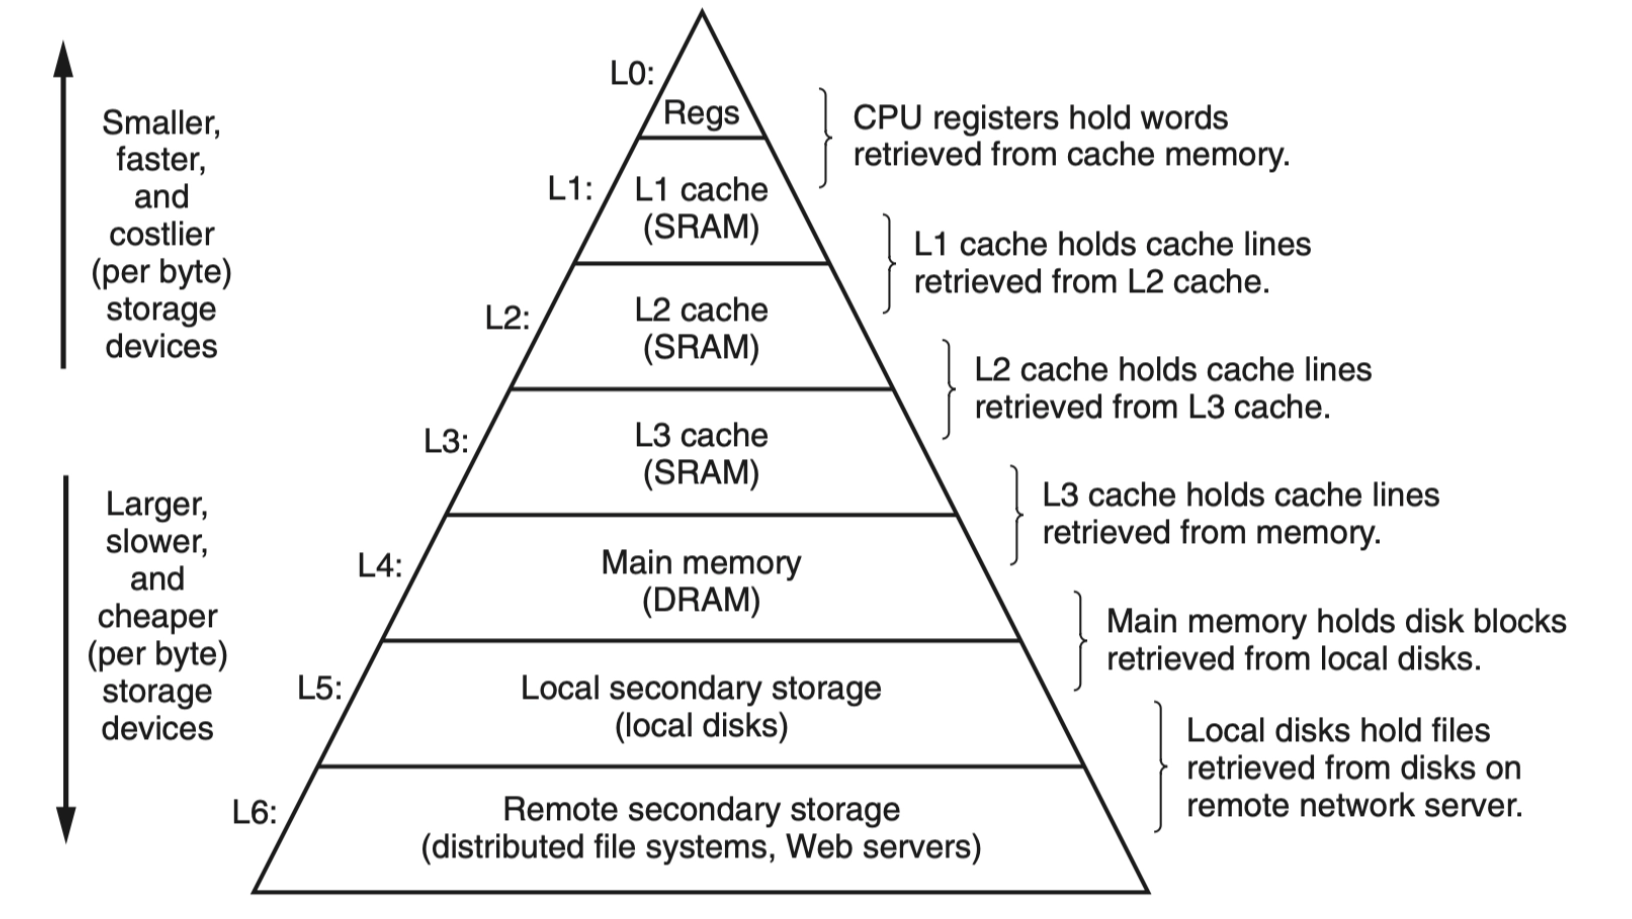
- CPU 는 L0 → L1 → L2 → … → L6 순서로 가지고 있는지 물어봄
- 위쪽 : 빠름 & 공간 작음 & 비쌈
- 아래쪽 : 공간 큼 & 느림 & 쌈
- L0 (Register) & L4 (Main Memory) → program code (assembly) 에 의해 controll 가능
- Cache (L1 ~ L3) 는 program code (assembly) 가 존재 여부 모름.
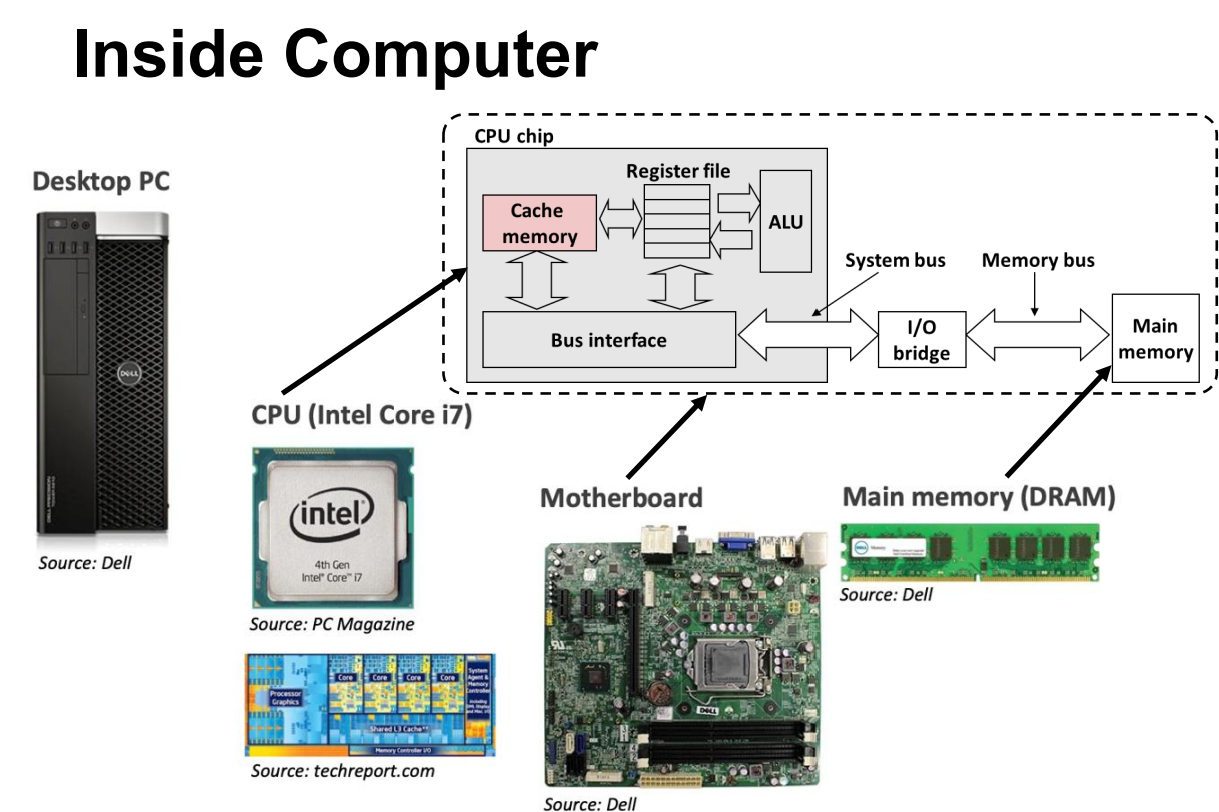
- 컴퓨터의 내부 구조
✦ Structure of cache memory
◆ Set, line and block
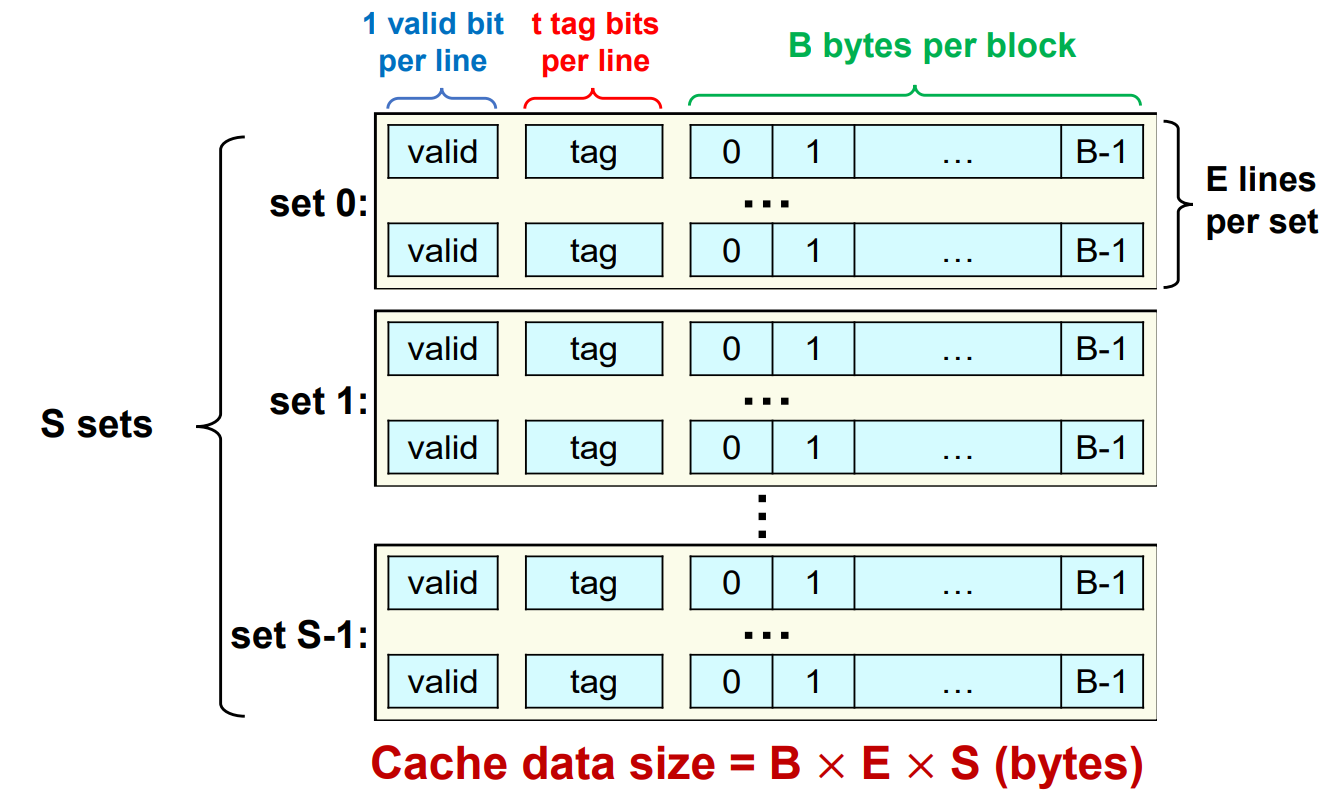
- cache 는 S 개의 set 으로 이루어져 있음
- 각 set 은 E 개의 line 으로 이루어져 있음
- 각 line 은 1 valid bit + t tag bit + B 개의 block 으로 이루어져 있음
- 각 set 은 E 개의 line 으로 이루어져 있음
- 총 Cache data size = B × E × S (valid, tag 는 무시)
◆ Operation of Cache Memory
-
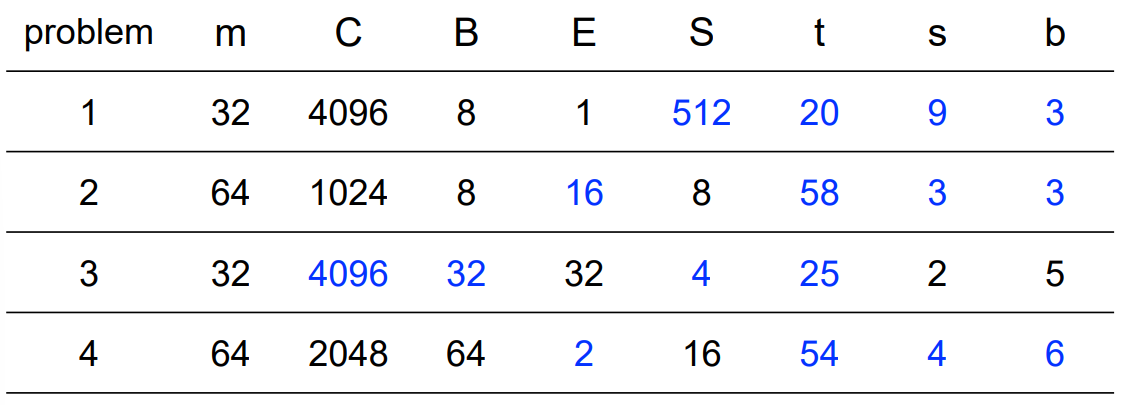
어떤 주소 x 에 접근하고 싶음 → m bit 를 t / s / b 로 나누기
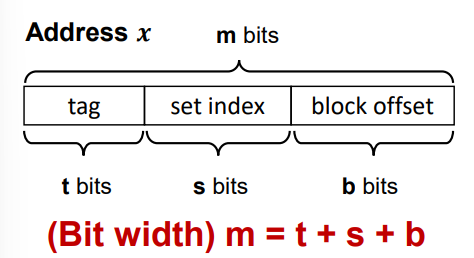
- m : 주소 길이 bit
- t : tag → tag 로 사용
- s : set index → 몇 번째 set 사용할지 결정
- b : block offset → 몇 번째 block 사용할지 결정
-
Example
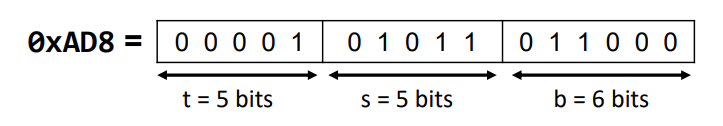
- b → 6 bits
- 2^6 → block 기준이 64 byte
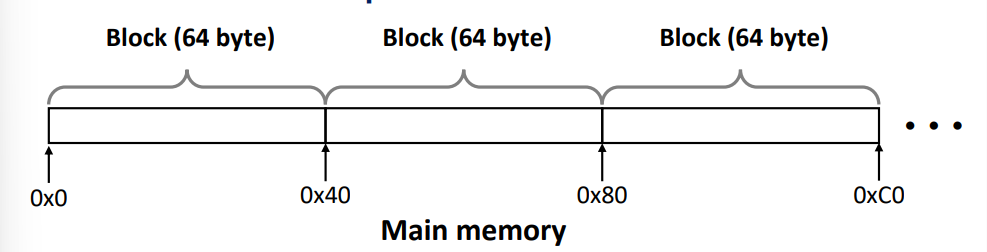
- 2^6 → block 기준이 64 byte
- s = 11 → 11 번 set 사용
- b = 24 → 24 번째 block 사용 (0xAC0 ~ 0xB00)
- t = tag
0 0 0 0 1→ line 선택 시 사용
- b → 6 bits
-
set 에서 line 이 1개면 → cache miss 시 전체가 새 block 으로 교체
◆Exercise
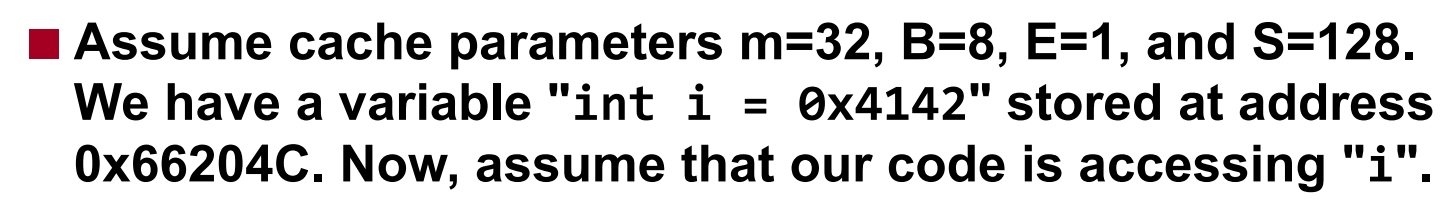
- i 가 보함된 block 의 address 범위?
- B 가 8 이므로 8 byte 단위
- i 는 4 byte + little endian 이므로
0x66204C는 4 ~ 7 - 따라서 총 범위는
0x662048~0x662050
- 이 block 이 저장되어 있는 set 의 번호는?
- m = t + s + b
- 32 = 22 + 7 + 3
0x66204C=......000001001100- 이중 s 는
0001001⇒ 따라서 9번 set
- block 의 4 ~ 7 offset 에 저장되어 있는 값은?
- little endian 방식 ⇒
4241저장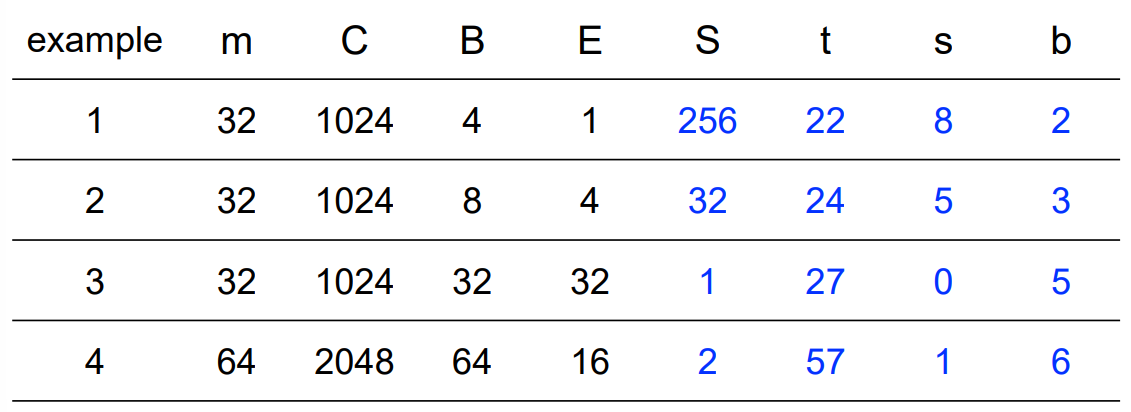
- little endian 방식 ⇒
✦ Three kinds of cache mapping
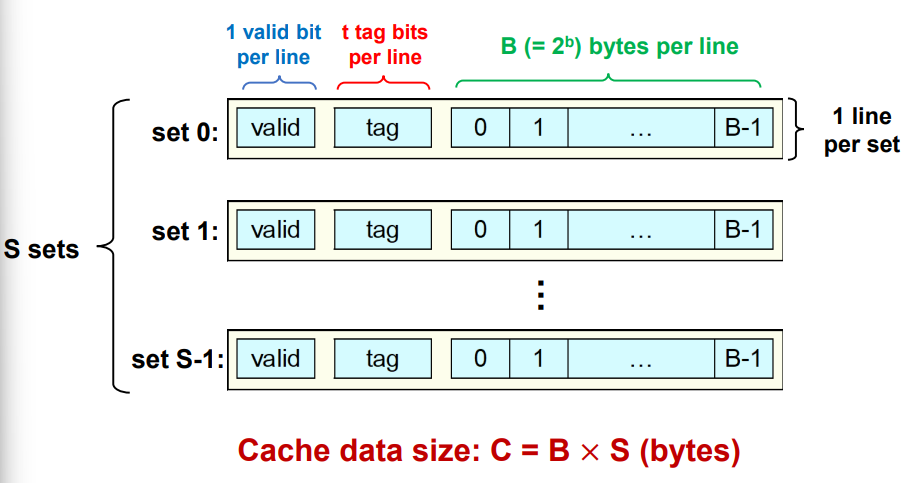
◆ Direct-mapped cache
- E 를 1 로 고정
- 각 Set 당 line 1개
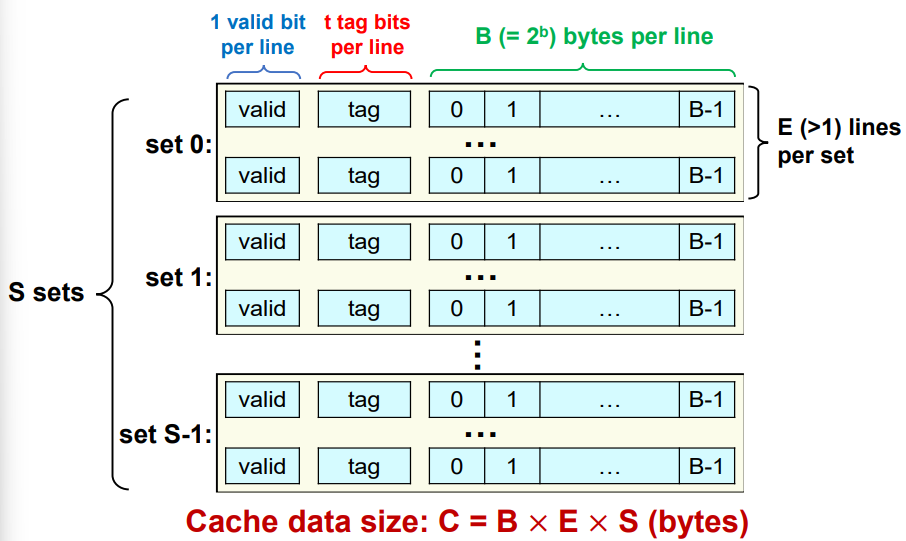
◆ Set-associative cache
- E > 1 && S > 1
- set 여러 개 & line 여러 줄
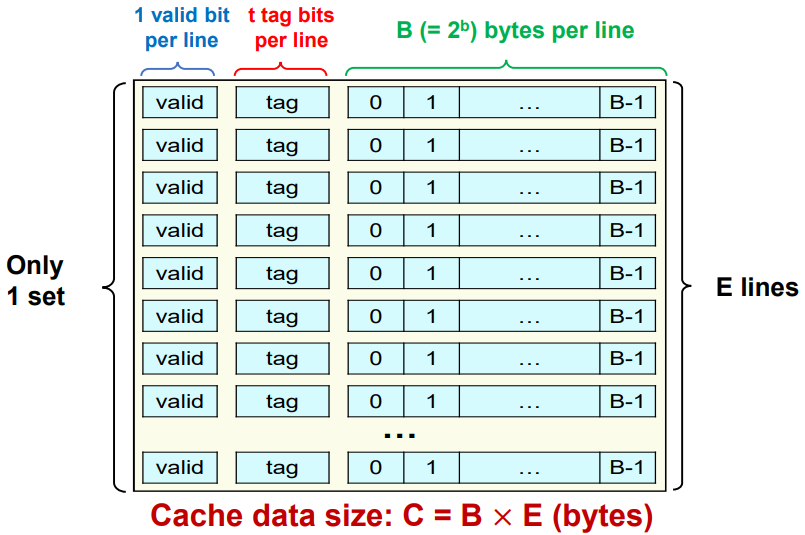
◆ Fully associative cache
- S 를 1로 고정
- 모든 line 이 1개의 set 에 존재
✦ Analyzing cache hit and cache miss
- 예시 : Direct-Mapped Cache 기준 (1 set - 1 line)
◆ Cache hit rate and miss rate
- 접근할 주소 주어짐
- set bit (s) 통해 어느 set 인지 찾기
- 여러 block 이 같은 set 에 mapping 될 수 있음 (컴아키 Hashing)
- valid bit check
- valid bit == 1
- valid bit == 0 ⇒ cache miss
- tag bit (t) check
- tag bit 일치 ⇒ cache hit
- tag bit 일치 XX ⇒ cache miss
- cache hit ⇒ block offset (b) 으로 원하는 데이터 찾기
- cache miss ⇒ 아래 과정 수행 후 재접근
- 해당 set 에 block 을 불러옴 (원래 내용 덮어쓰기)
- valid bit 0 → 1 로 바꾸기
- tag bit (t) 업데이트
- set bit (s) 통해 어느 set 인지 찾기
- Cache hit rate = \frac{hit 성공}{전체 접근}
- Cache miss rate = 1 - cache hit rate
◆ Example
- Notation
- 가정 : cache memory 는 초기에 비어있다 → 처음 데이터는 항상 miss
- 표기
| 표기 | 의미 |
|---|---|
sizeof(int) = 4 |
주어진 자료형의 크기 명시 (바이트 단위) |
int value_1 @ 0x8800200C |
main memory 에서 변수의 자료형 & 주소 명시 |
int arr[512] @ 0xAAAA0000 |
main memory 에서 배열의 자료형, 크기, 시작 주소 명시 |
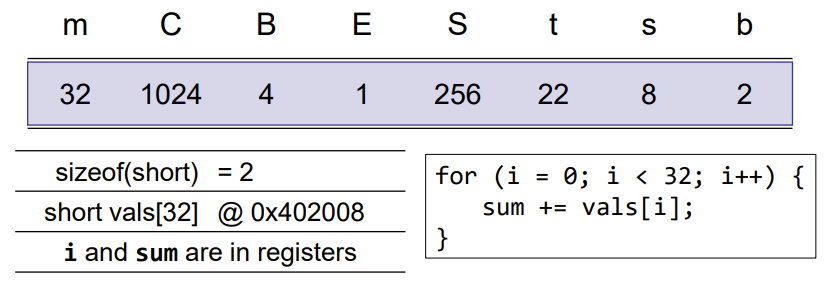
- block 크기 4 byte
- set 256 개
- Q.
vals[0],vals[1],vals[2]… 는 어디 set 에 저장?vals[0]→0100 0000 0010 00|00 0000 10|00
→ s 가 2 이므로 set 2 에 저장
vals[0-1] = set 2 vals[2-3] = set 3 … vals[30-31] = set 17 에 저장
- Q. 이 code 의 hit rate 는? 짝수는 miss & 홀수는 hit
16 miss & 16 hit → 50% hit rate
- Q. code 를 이렇게 바꾸면 hit rate 는? 계속 miss 하게 되므로 0%
◆ Thrashing
- 방법 1 : Set 갯수 (S) 늘리기
- 방법 2 : line (entry) 갯수 늘리기
- direct mapped → set-associative / fully associative 사용
- Line check?
- valid bit → 사용 중인 line?
- tag bit → 주소의 tag 랑 일치?
- Set-Assiociative
- set indext (s) 로 set 선택
- valid = 1 && tag bit 일치 → cache hit
-
valid ≠ 1 tag bit 불일치 → cache miss
- set indext (s) 로 set 선택
◆ Replacement policy
- LRU (Least Recently Used)
- 각 line 마다 Age 설정
- 선택된 line 은 0 으로 초기화
- 나머지 line 은 +1
| Direct mapped cache (직접 사상 캐시) | Set associative cache (집합 연관 캐시) | Fully associative cache (완전 연관 캐시) | |
|---|---|---|---|
| 장점 | • 구조가 단순함 • 접근 속도 ↑ • miss penalty ↓ |
(중간 성격 — 양쪽의 절충) | • thrashing ↓ • hit rate ↑ |
| 단점 | • thrashing ↑ • hit rate ↓ |
(중간 성격 — 양쪽의 절충) | • 구조가 복잡함 • 접근 속도 ↓ • miss penalty ↑ |
✦ Cache Performance
- Hit Time (HT)
- cache data → CPU 도달 걸리는 시간
- block 이 cache 에 있는지 판단하는 시간 포함
- Miss Penalty (MP)
- miss 때문에 발생하는 추가 시간
- 시간 소요
- Cache hit : Hit Time
- Cache miss : Hit Time + MP’
$$
\text{AMAT} = \text{HT} + \text{MR} \times \text{MP}
$$
- AMAT : Average Memory Access Time
- Multi-level Cache
$$
\begin{align*}
\text{AMAT}_i &= \text{HT}_i + \text{MR}_i \times \text{MP}_i \\
&= \text{HT}_i + \text{MR}_i \times \text{AMAT}_{i+1}
\end{align*}
$$
◆ Cache-Friendly Code
공유하기
Twitter Facebook LinkedIn글 이동
시리즈 이동
Comments