[Algorithm] Introduction
'알고리즘 설계와 분석' 시리즈
✦ Introduction
◆ Algorithms and their design and analysis
- 왜 알고리즘을 사용해야 하는가?
- 수학 → solution 이 명확
- computer program → 어떤 것이 좋은 프로그램인가?
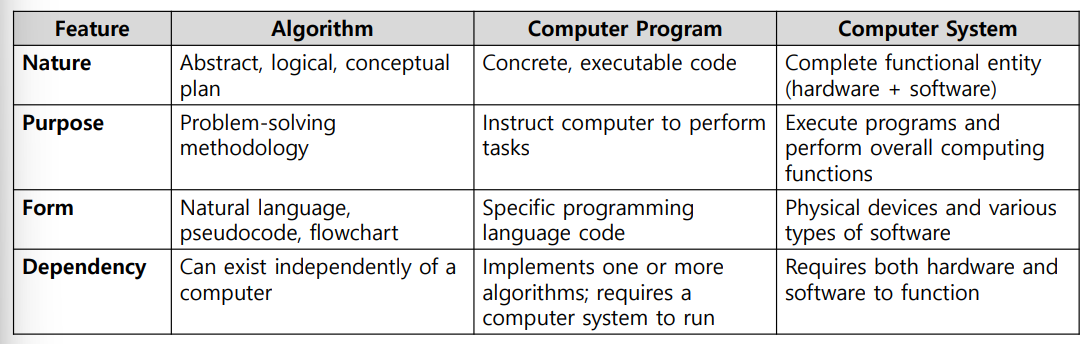
- 알고리즘 설계
- 절차
문제 이해, 정의 → solution idea 고안 → 구체화 → 성능 평가 → 실제 구현 & 테스트 - Solution idea → 알고리즘 paradigm
- Brute Force
- Divide and Conquer
- Dynamic Programming
- Greedy Algorithm → Data size & 구조에 따라
- 절차
- 알고리즘 분석
- 기준이 무엇인가? 알고리즘이 사용하는 resource
◆ An Example of Algorithms : Insertion Sort
- Sorting Problem : n 개의 숫자를 순서대로 나열하기
- Input : A sequence of n numbers <a_1, a_2, …, a_n>
- Output : <a_1’, a_2’, …, a_n’> such that a_1’ ≤ a_2’ ≤ … ≤ a_n’
- Sorting algorithm
- Bubble, Selection, Insertion, Shell, Merge, Heap, Quick, Counting, Radix, Bucket 등
- 어떤 알고리즘이 좋은 알고리즘인가?
- Example : Insertion Sort
INSERTION_SORT(arr[] A, int n) // A = 배열, n = A 의 size
	for i = 2 ~ n
		key = A[i] // 현재 element 값
		// A[i] 를 정렬된 subarray A[1:i-1] 의 적절한 위치에 넣기
		// A[1:i-1] 은 이미 정렬되어 있음
		j = i - 1
		while j > 0 && A[j] > key
			A[j+1] = A[j]
			j = j - 1
		A[j+1] = key
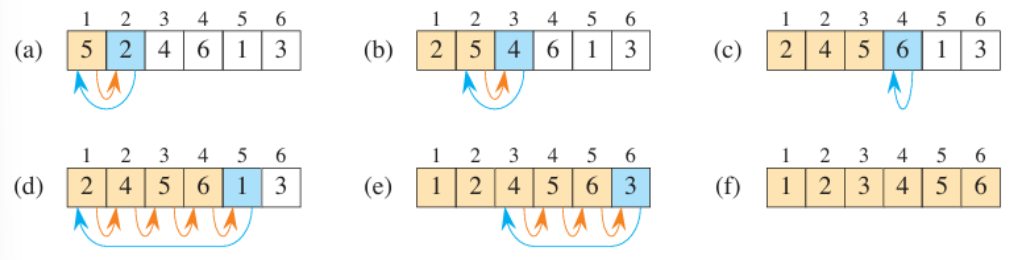
- Sorting 과정
- i : → 이쪽으로 이동
- j : ← 이쪽으로 이동하면서 자신보다 작은 값이 나올 때까지 비교 / 큰 값이면 swap
◆ Loop Invariant
- Loop Invariant : 루프 불변성
- 어떤 알고리즘이 원하는 결과를 만들어 낸다는 것을 보여주는 방법
- 정의되어 있는 loop (for, while) 이 동작 했을 때 원하는 결과가 나옴
- 조건
- Before : loop 시작 전 원하는 상태
- After : loop 끝난 후 원하는 상태
- When : 모든 loop 끝났을 때 원하는 상태 → 세 조건 만족 시 루프 불변성 O
- ex) insertion sort 의 loop invariant :
A[i]에 대해서,A[1:i-1]이 정렬되어 있다는 것 보이기.
◆ Analyzing Algorithms
- 알고리즘 분석 : resource 를 얼마나 사용하는가?
- resource : time, memory, time, 통신 bandwidth, 전력 사용량 등 → 알고리즘 분석 시 보통 computational time (계산 시간) 위주
- 실행 시간 분석
- 물리적 실행 횟수 X
- 실제 code 가 실행되는 횟수 기반
- ex) insertion sort
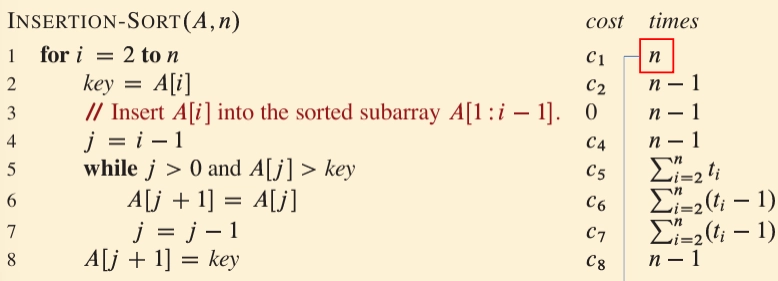
i = n + 1 일 때도 비교해야 함.
- 전체 cost? → 총 cost 모두 저하기
- best case : 이미 정렬 완료 → while loop X ⇒ an + b
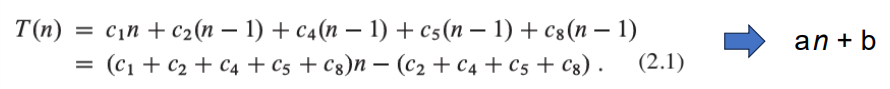
- worst case : 정반대 순서로 정렬 ⇒ an^2 + bn + c
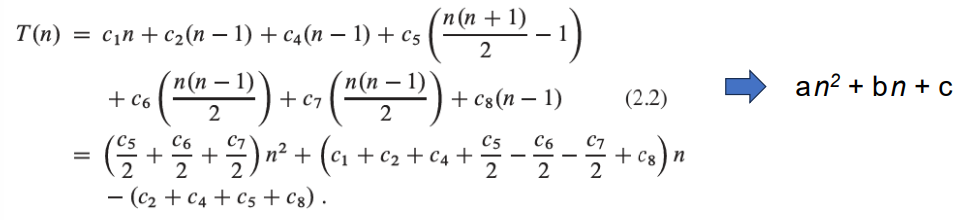
  - 보통 알고리즘 성능 판단 기준
- average case : 정확히 정리 어려움 → 같은 알고리즘도 입력 따라 실행 시간 달라짐
- Order of Growth (증가 차수)
- an < an^2
- 입력값 n 에 대한 차수로 판단 (a, b 는 상수)
◆ Designing Algorithms
- 알고리즘 설계
- 같은 sorting, 다른 algorithm
- insertion sort : incremental method
- merge sort : divide-and-conquer → merge sort 의 성능?
- Example : Merge Sort → Divide-and-Conquer 사용
- Divide : n 개의 입력을 쪼갬
- Conquer : 쪼갠 입력에 대해 같은 방식으로 풀기
- Combine : 계산한 값들을 다시 합치기
- Divide :
arr A[p~r]를 두 개로 나누기 (p ~ q / q+1 ~ r) - Conquer : 나눠진 두 배열
A[p~q],A[q+1~r]를 각각 sorting - Combine : 정렬된 두 배열 합치기
MERGE_SORT(arr[] A, start p, end r) {
	if p >= r // 요소가 1개 이하
		return
	q = (p+r) / 2

	// Divide & Conquer
	MERGE_SORT(A, p, q) // p~q 까지 재귀적으로 sort
	MERGE_SORT(A, q+1, r) // q+1 ~ r 를 재귀적으로 sort

	// Combine : 두 배열 합치기
	MERGE(A, p, q, r)
- MERGE
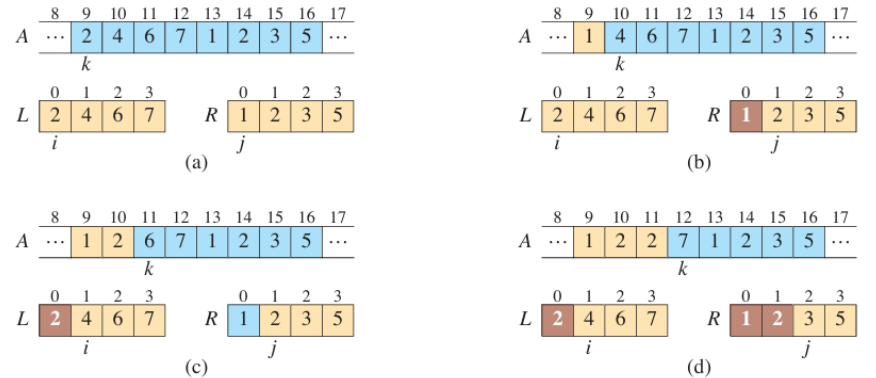
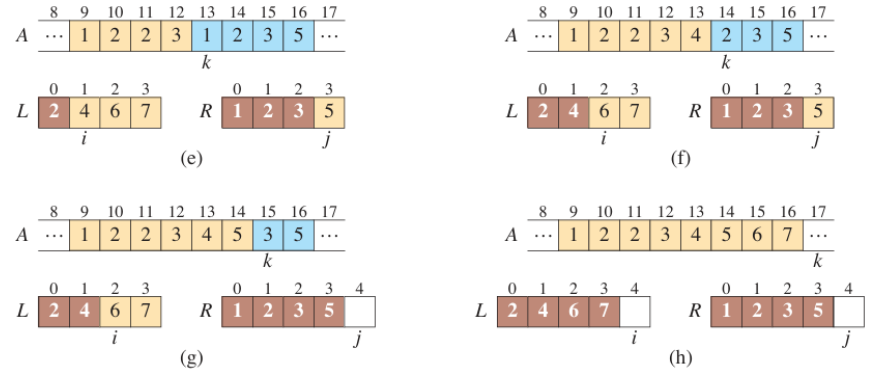
- L / R 의 맨 앞 요소 비교해 더 작은 값을 원래 배열에 저장
- 한쪽 끝 도달 시 반대 쪽 끝 나머지 모두 옮기기
- 시간 ↔ 공간 tradeoff - Divide-and-Conquer 의 성능 평가 - 점화식 작성 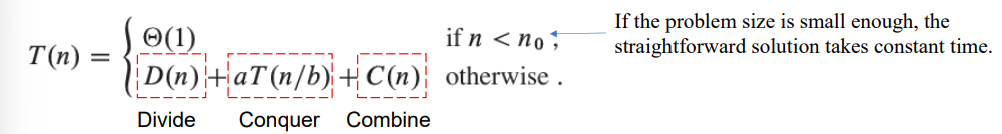
- Θ(1) : element 갯수가 작을 때 → base case
- D(n) + aT(\frac{n}{b}) + C(n)
- Conquer(T) a → 재귀 호출 횟수 b → 데이터 분할 비율
- Example : Merge sort
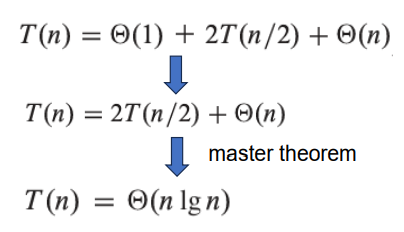
⇒ Time complexity = O(n \lg n)
✦ Charaterizing Running Times
-
목표 : running time 나타내는 표기법 알기
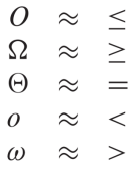
- Big-O / Big-Omega / theta / Small-o / Small-omega
◆ The Asymptotic Efficiency of Algorithm
- 알고리즘의 점근적 (Asymptotic) 성능
- line-by-line 분석 X
- 대략적 분석 O (input 이 큰 상황)
- 상수 무시
◆ O-notation
- 알고리즘 성능 측정에 주로 많이 사용
- Upper bound (상한) : 아무리 시간이 많이 걸려도 이 시간을 넘진 않음
-
ex) f(n) = 7n^3 + 100n^2 -20n + 6 → O(n^3) O(n^c) for any constant c ≥ 3 → 상한이므로 3차 이상의 차수도 괜찮음.
- 함수에서 가장 차수가 높은 항 (계수 무시)
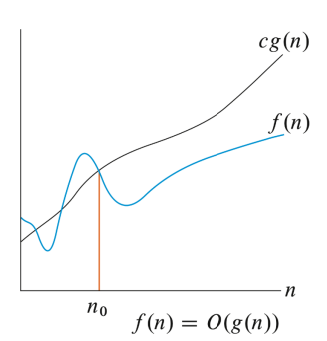
- 함수에서 가장 차수가 높은 항 (계수 무시)
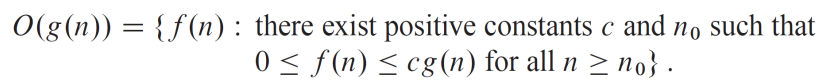
- n_0 이후에서 항상 f(n) 의 위쪽에 존재
-
g(n) 은 f(n) 의 점근적 상한 (asymptotic upper bound)
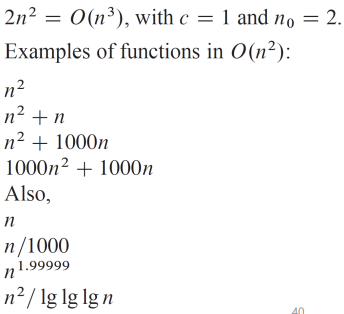
- O(n^3) 은 n_0 = 2 이후 부터 모든 O(n^2) 함수보다 크다.
◆ Ω-notation
- Lower bound (하한) : 아무리 빨라져도 이만큼의 시간은 걸린다
- ex) f(n) = 7n^3 + 100n^2 -20n + 6 → \Omega(n^3) \Omega(n^c) for any constant c ≤ 3 → 하한이므로 3차 이하의 차수도 괜찮음. (하지만 의미가 별로 없음)
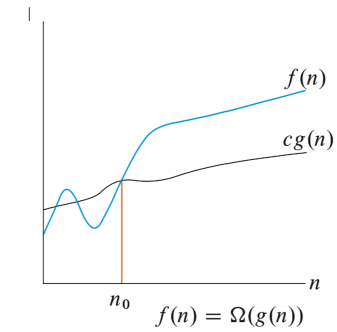
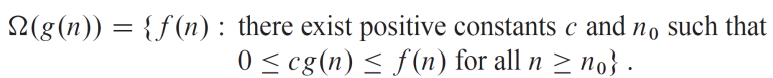
- n_0 이후에서 항상 f(n) 의 아래쪽에 존재
- g(n) 은 f(n) 의 점근적 하한 (asymptotic lower bound)
◆ Θ-notation
- Tight bound : 거의 정확하게 맞는 범위
- Big-O = Big-Ω ⇒ Θ
- 상한과 하한이 동일함
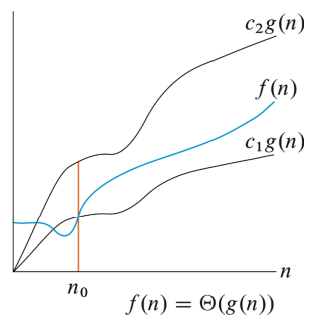
- 상한과 하한이 동일함
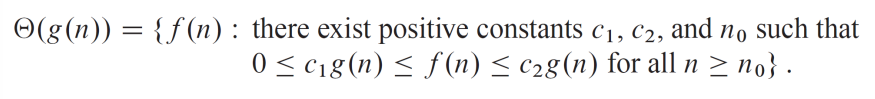
- g(n) 은 f(n) 의 점근적 tight bound
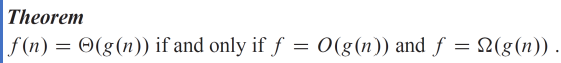
| 표기법 | 의미 | 비유 | 보장하는 것 |
|---|---|---|---|
| O(g) | 점근적 상한 | ≤ | f는 g보다 빠르게 자라지 않는다 |
| Ω(g) | 점근적 하한 | ≤ | f는 g만큼은 자란다 |
| Θ(g) | 점근적 타이트 바운드 | = | 위 두 개를 동시에 만족 |
Θ → 독립된 세 번째 표기법 X, O와 Ω가 같은 g에서 만나는 지점
◆ Example : Insertion Sort
- 점근적 해를 구하시오 → 점근적 표기를 하시오
- 어떤 case 를 기준으로 해야하는가? → worst case 기준
INSERTION_SORT(arr[] A, int n) // A = 배열, n = A 의 size
	for i = 2 ~ n
		key = A[i] // 현재 element 값
		// A[i] 를 정렬된 subarray A[1:i-1] 의 적절한 위치에 넣기
		// A[1:i-1] 은 이미 정렬되어 있음
		j = i - 1
		while j > 0 && A[j] > key
			A[j+1] = A[j]
		A[j+1] = key
- Upper bound : 입력이 어떻든 상한이 O(n^2)
- 최악의 경우에도 O(n^2) 을 넘지 않음
- 바깥 for : n-1 회 실행
- 안쪽 while : i-1 회 실행 → 전체 실행 (n-1)(n-1) ⇒ O(n^2)
- 최악의 경우에도 O(n^2) 을 넘지 않음
- Lower bound : 입력이 최소여도 하한이 \Omega(n^2)
-
worst case 에서 n^2 만큼 걸리는 입력이 적어도 하나 존재함을 보임
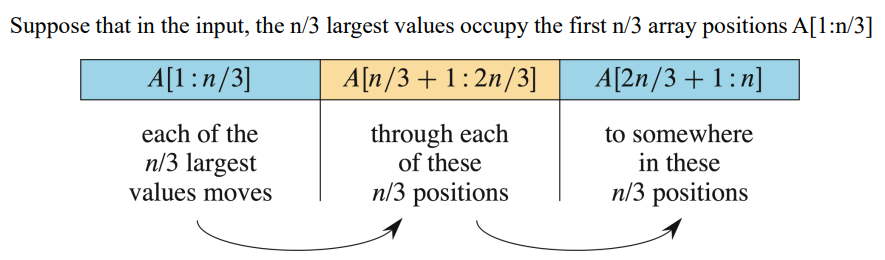
- 구간이 3개로 나눠질 때 → worst case 이므로 큰 값들이 맨 처음 구간
A[1:n/3]에 있음 - 적절한 위치로 가기 위해서는 적어도 중간 구간을 통과해야함 → 최소 \frac{n}{3} 씩 이동
-
$$
\underbrace{\frac{n}{3}}_{\text{이동하는 값의 개수}} \times \underbrace{\frac{n}{3}}_{\text{각자 이동하는 최소 거리}} = \frac{n^2}{9}
$$
→ 따라서 최소로 이동한다고 하더라도 n^2 만큼의 시간 필요 ⇒ \Omega(n^2)
- Tight bound
- worst case 에 대해 O(n^2) = \Omega(n^2) ⇒ \Theta(n^2)
◆ Asymptotic Notation and Running Times
- 점근 표기법은 함수에 붙는 것이지, 알고리즘에 붙는 것이 아니다
- 어떤 case 의 함수에 붙이는지 필요
- ex) Insertion sort
- worst case → \Theta(n^2)
- best case → \Theta(n)
- ex) Insertion sort
-
case 명시 없이 쓰기 위해선 모든 입력에서 차수가 동일해야 함!
- Insertion → 불가능 / Merge → 가능
◆ Extra
-
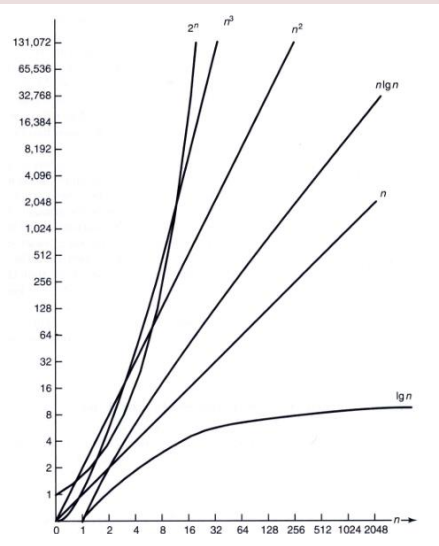
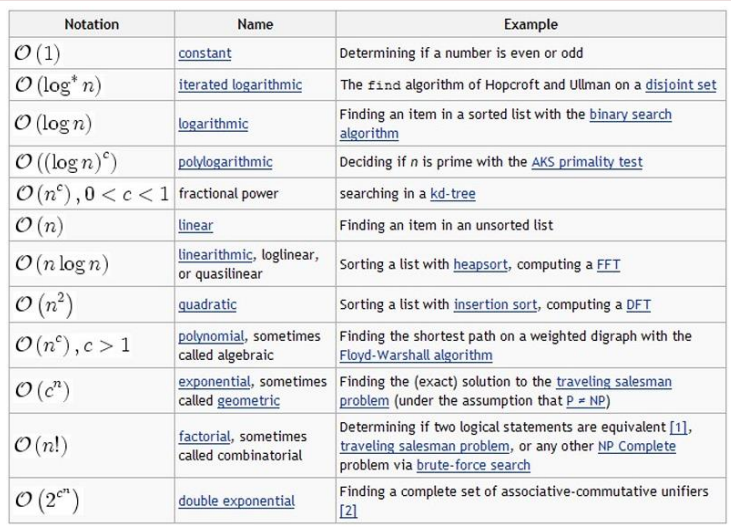
Time Complexity 별 증가율
-
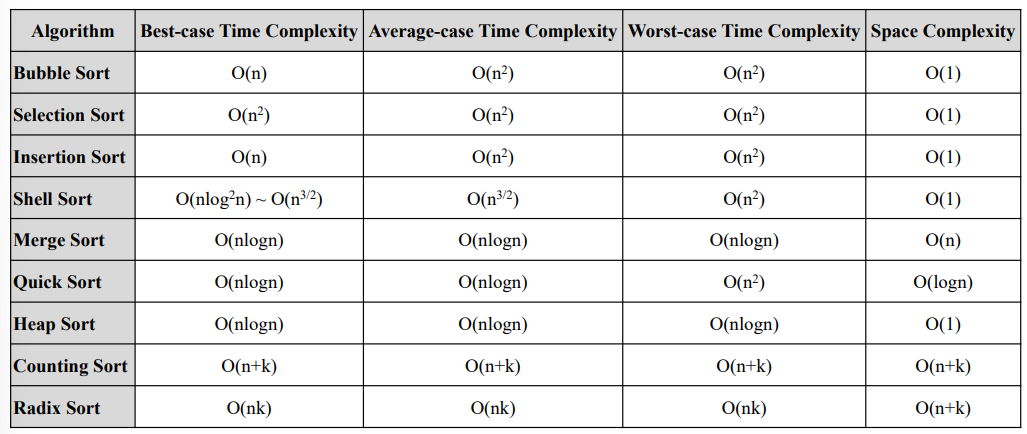
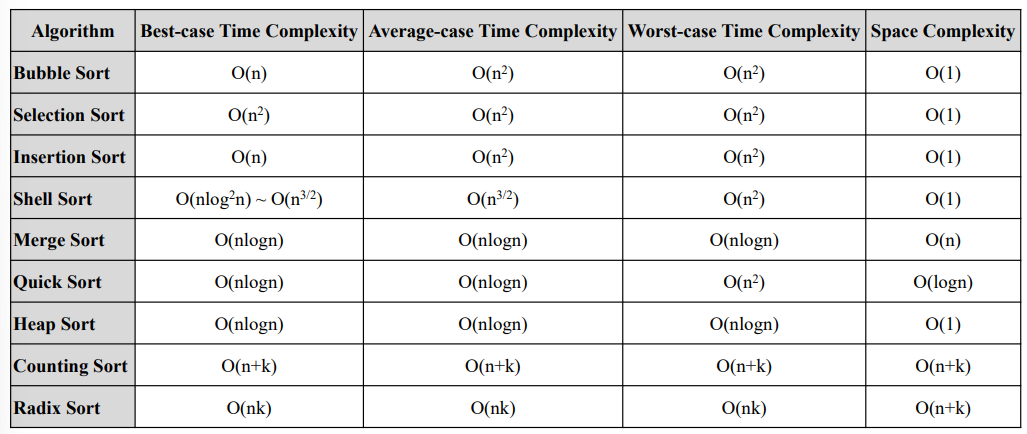
알고리즘 별 Time Complexity
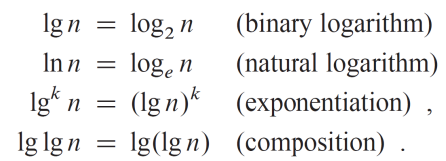
공유하기
Twitter Facebook LinkedIn글 이동
시리즈 이동
Comments